 正版
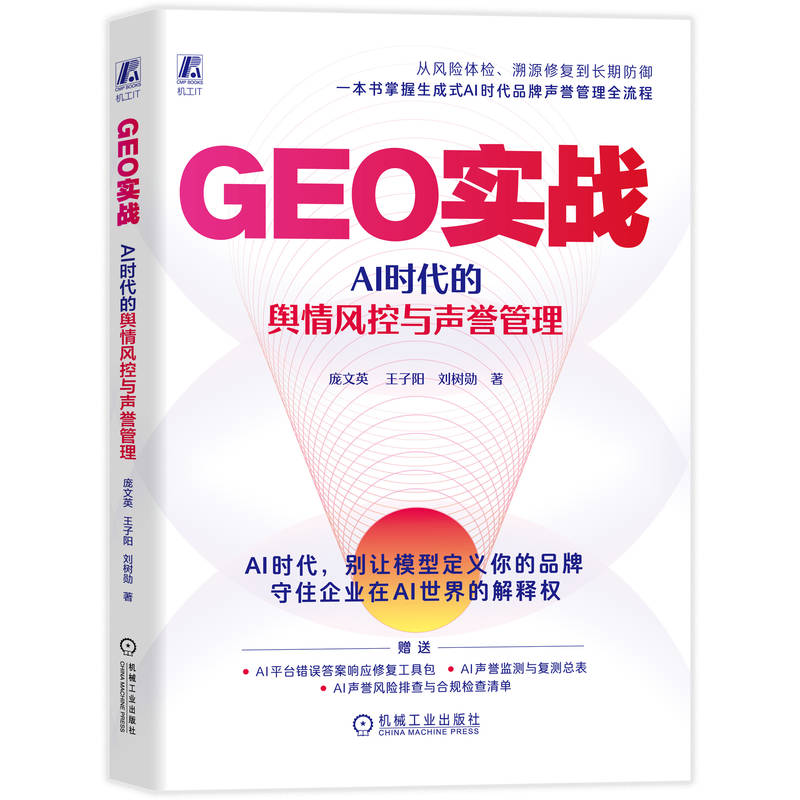
GEO实战:AI时代的舆情风控与声誉管理
- 书名
- GEO实战:AI时代的舆情风控与声誉管理
- 作者
- 庞文英 王子阳 刘树勋 著
- 出版社
- 机械工业出版社
- 出版时间
- 2026-11-01
- ISBN
- 9787111822202
- 货号
- 1204674886
- 品相
- 全新
- 分类
- 涉及古代·经济
- 书名
- GEO实战:AI时代的舆情风控与声誉管理
- 作者
- 庞文英 王子阳 刘树勋 著
- 出版社
- 机械工业出版社
- 出版时间
- 2026-11-01
- ISBN
- 9787111822202
- 货号
- 1204674886
- 品相
- 全新
- 分类
- 涉及古代·经济
编辑推荐▼
1. 作者权威:本书3位作者均为数字营销领域的资深专家,有丰富的实战经验。
2. 内容独特:市面上第一本从舆情和风险防控角度讲解GEO技术的图书。
3. 实战性强:赠送可立即使用的工具包等。
作者简介▼
1. 庞文英
传播学、管理学硕士,现任中国商务广告协会数字营销资深研究专家、清华大学经管学院商业模式创新研究中心产业学者、中国移动新媒体战略顾问、虎啸奖数字营销类评委,并兼任经济网、中国产业经济信息网等多家主流媒体特邀顾问。
多年来深度参与高校与政府机构培训体系建设,专注营销传播人才的实战转化及搜索营销算法研究,深耕SEO、GEO与网络舆情公关领域22年,长期
专注于智能传播与GEO融合应用的研究与实践。
主导小仙炖品牌SEO+GEO战略11年实操,助力其成长为行业领军品牌;长期负责国内头部金融企业舆情管理,成功协助企业平稳处理重大舆情事件。为中金公司、中国移动、中国人寿、蓝月亮、链家、TCL、雀巢、唯品会、红牛、云迹科技、小仙炖、我爱我家、链家地产、八马茶叶、金风科技、完美日记、爱康国宾等国内外100余家头部企业提供智能传播与舆情管理方案。
2. 王子阳
清华大学经管学院商业模式创新研究中心研究主管,西安交通大学物流科创融合发展与研究中心副研究员,专注于研究AI增长与商业模式创新,曾带队为多家企业解决商业模式难题,并在国内外顶级管理类杂志发表多篇文章。曾任天娱数科(002354)独立董事。合作研究的典型客户有字节跳动(抖音、飞书)、美团、小米、京东、海尔、浦发银行、艾博生物、兰湘子、第四范式等。
3. 刘树勋
智推时代联合创始人。中国商务广告协会《生成式引擎优化(GEO)》团队标准》参编专家。清华大学经管学院《快学习-GEO营销趋势》主讲嘉宾。曾入选福布斯&胡润创业榜。为招商银行、自然堂、三七互娱、比亚迪汽车、新东方等头部品牌提供GEO咨询和服务。
目录▼
自序 从被AI推荐,到不被AI伤害
总论篇 AI 是怎样伤害品牌的
第1 章 AI 舆情不是传统舆情的延伸:从传播管理到模型认知治理 / 2
1.1 从传统公关到AI 声誉治理:三代公关逻辑的变化 / 4
1.1.1 传统公关:争夺媒体报道权 / 4
1.1.2 互联网公关:争夺搜索可见权与社交声量权 / 5
1.1.3 AI 大模型公关:争夺模型认知权与答案推荐权 / 6
1.1.4 公关逻辑的跃迁:从控制传播到治理认知 / 7
1.1.5 AI 为什么成为新的信任分配者 / 8
1.1.6 “塔西佗陷阱”在AI 时代的放大效应 / 9
1.2 AI 作为“信息再造者”:摘要、聚合与幻觉 / 9
1.2.1 摘要:AI 如何压缩信息并丢失上下文 / 11
1.2.2 聚合:跨源拼接带来的“张冠李戴” / 11
1.2.3 幻觉:AI 在信息缺口处的“自信编造” / 13
1.2.4 权威语气:为什么AI 错误更容易被相信 / 14
1.2.5 网民心理特征:为什么AI 会“捕捉”到差评 / 14
1.3 为什么说“被推荐”比“被搜索”更危险 / 15
1.3.1 搜索时代:用户主动筛选,品牌仍有解释机会 / 16
1.3.2 AI 推荐时代:答案即终点,点击行为减少 / 16
1.3.3 “被推荐”:品牌进入AI 答案后的机会与风险 / 17
1.3.4 从搜索排名到答案占位:品牌竞争进入新阶段 / 17
1.3.5 平台AI 的差异化危险:不同AI 的推荐逻辑与风险形态 / 18
1.4 AI 声誉风险的早期预警信号 / 19
1.4.1 AI 答案本身的异常信号 / 20
1.4.2 用户行为的异常信号 / 21
1.4.3 平台动态的异常信号 / 21
1.4.4 风险升级前的预警信号 / 22
1.4.5 信任偏差如何放大AI 声誉风险 / 22
本章小结:AI 时代,公关进入模型认知治理阶段 / 24
第2 章 AI 为什么会误读企业:从旧数据、外部检索到模型幻觉 / 25
2.1 AI 不是实时事实库 / 25
2.1.1 大模型旧知识会滞后于企业现实 / 26
2.1.2 旧数据与历史信息带来的四类偏差 / 26
2.2 模型印象不是固定答案:提问语境会改变AI 判断 / 27
2.2.1 高频信息:反复出现的词会变成默认标签 / 28
2.2.2 高权重来源:权威信息会影响AI 判断 / 28
2.2.3 情绪信息:用户评价会改变AI 语气 / 29
2.2.4 缺失信息:企业不说,AI 可能从外部补全 / 29
2.2.5 错误信息:旧新闻、同名企业、竞品信息如何污染模型认知 / 29
2.3 RAG 机制:外部内容如何进入AI 答案 / 30
2.3.1 什么是RAG:检索增强生成的基本逻辑 / 30
2.3.2 AI 如何决定“引用谁” / 30
2.3.3 为什么第三方内容有时比官网更容易被采信 / 31
2.3.4 RAG 带来的五类声誉风险 / 31
2.3.5 引用源不一致,会让AI 答案摇摆 / 32
2.4 模型幻觉:信息缺口如何变成错误事实 / 32
2.4.1 幻觉与谣言:不同来源,相同危害 / 33
2.4.2 信息缺口越大,幻觉空间越大 / 33
2.4.3 多信号冲突时,AI 可能生成折中但错误的结论 / 34
2.4.4 强监管行业的幻觉风险:医疗、金融、教育、法律 / 34
2.5 企业信息生态中的五类AI 误读源 / 34
2.6 从误读到舆情:AI 错误如何进入真实商业场景 / 36
本章小结:AI 误读来自信息生态的长期沉积 / 38
第3 章 AI 声誉风险地图:从AI 答案到经营风险 / 39
3.1 三大伤害模型:错误事实、过时信息、评价污染 / 40
3.1.1 错误事实:AI 对企业“描述失实” / 40
3.1.2 过时信息:AI 把过去当成现在 / 41
3.1.3 评价污染:AI 把片面声音当成整体口碑 / 42
3.2 不同AI 入口的差异风险:通用大模型、AI 搜索、内容平台AI 摘要 / 42
3.2.1 通用大模型:容易形成“概括性品牌印象” / 43
3.2.2 AI 搜索:容易放大引用源问题 / 44
3.2.3 内容平台AI 摘要:容易受平台内容生态影响 / 44
3.3 行业风险热力图:谁最容易被AI 误读 / 45
3.3.1 高信任门槛场景:医疗、金融、教育、法律服务 / 45
3.3.2 高评价敏感场景:电商、消费品、本地生活、医美服务 / 46
3.3.3 高对比决策场景:B2B、SaaS、制造业、专业服务 / 46
3.3.4 高争议扩散场景:加盟、招商、连锁服务、房地产中介 / 47
3.4 AI 主动生成舆情:从误读风险到攻击风险 / 47
3.4.1 AI 生成舆情的五类风险 / 48
3.4.2 企业识别AI 生成舆情的早期信号 / 49
本章小结:AI 声誉风险是一张需要持续更新的地图 / 50
方法篇 GUARD 品牌AI 声誉防御模型
第4 章 体检(Gauge):建立 AI 声誉监测体系 / 52
4.1 定入口:以大模型为基础,补充观察其他 AI 入口 / 53
4.1.1 大模型入口:检查 AI 对企业的总体认知 / 54
4.1.2 AI 搜索入口:观察搜索场景中的摘要与引用 / 54
4.1.3 垂直媒体与内容平台AI 入口:观察口碑标签是否被固化 / 55
4.1.4 企业自有AI 入口:检查企业自己的问答口径 / 57
4.1.5 入口优先级:先测最接近经营结果的地方 / 57
4.2 定问题:建立场景问题体系 / 58
4.2.1 六类场景:品牌、产品、风险、合规、竞品、决策 / 58
4.2.2 关键词的作用:生成问题、归类答案、标记风险 / 59
4.2.3 启动版20 问:第一次监测先做小闭环 / 59
4.3 定节奏:月度监测、季度复盘、危机期加密 / 60
4.3.1 月度监测:建立AI 声誉基线 / 60
4.3.2 季度复盘:观察风险趋势和修复效果 / 61
4.3.3 危机期加密:重大事件后的连续复测 / 61
4.4 定方法:问出隐藏风险 / 62
4.4.1 负面限定词提问 / 62
4.4.2 角色场景提问 / 62
4.4.3 连续追问 / 63
4.4.4 反向验证 / 63
4.5 定记录:台账、截图和版本管理 / 64
4.5.1 监测台账记录哪些字段 / 64
4.5.2 截图和引用源如何归档 / 65
4.5.3 建立AI 答案变化档案 / 65
4.6 定评分:把答案变成可管理指标 / 66
4.6.1 六维评分:事实、完整度、情绪、来源、推荐、影响 / 66
4.6.2 六个指标:准确率、负面率、谨慎率、旧信息率、竞品替代率、高风险率 / 66
4.6.3 初步等级:绿、黄、橙、红、黑 / 67
4.7 出报告:AI 声誉监测报告 / 68
4.7.1 报告首页怎么写 / 68
4.7.2 高风险问题清单怎么列 / 68
4.7.3 模拟示例:某教育品牌AI 声誉监测报告 / 69
本章小结:把 AI 声誉监测做成可复测的管理机制 / 70
第5 章 溯源(Uncover):AI 错误答案从哪里来 / 71
5.1 先判断:错误答案还是信源失真 / 72
5.1.1 有引用时:检查来源、时间和上下文 / 72
5.1.2 无引用时:从链接级溯源转向事实级溯源 / 73
5.1.3 多平台共同错误:信息生态已经发出信号 / 74
5.2 旧内容残留:时间失真如何塑造AI 旧认知 / 75
5.2.1 旧内容复活的三条路径 / 75
5.2.2 哪些企业更容易被旧内容误读 / 76
5.2.3 建立旧内容考古机制 / 76
5.3 用户评价污染:代表性失真如何变成品牌标签 / 77
5.3.1 用户评价污染的四种来源 / 78
5.3.2 多平台评价扫描与样本校正 / 78
5.3.3 如何判断用户评价背后的真实意图 / 79
5.4 模型幻觉与事实底稿缺失:信息缺口中的自动补全 / 80
5.4.1 什么是模型幻觉与融合错误 / 80
5.4.2 幻觉与融合错误的四种表现 / 81
5.4.3 为什么事实底稿缺失会让幻觉频发 / 81
5.4.4 建立幻觉风险检查表 / 82
5.4.5 企业事实底稿:减少AI 自由补全空间 / 82
5.5 AI 错误答案溯源图谱法与台账沉淀 / 83
5.5.1 四步法:捕获、拆解、映射、定位 / 84
5.5.2 优先定位关键错误源:高可见、高权重、高复现 / 84
5.5.3 溯源后的五类根因 / 85
5.5.4 AI 循环引用:当错误信息拥有多个来源 / 86
5.5.5 源头台账:把溯源变成管理记录 / 86
本章小结:溯源要回到引用源和事实源 / 87
第6 章 分级(Assess):哪些 AI 声誉风险必须优先处理 / 89
6.1 分级对象:AI 答案中的风险信号 / 90
6.2 三要素评估:严重度、当前传播状态、业务影响面 / 92
6.2.1 严重度:风险信号有多严重 / 93
6.2.2 当前传播状态:风险是否已经稳定出现 / 94
6.2.3 业务影响面:风险会进入哪个经营环节 / 95
6.2.4 基础等级确定:交叉初判与业务校准 / 96
6.3 最终分级:上调规则与同级排序 / 97
6.3.1 基础等级是否需要上调 / 97
6.3.2 同一等级内部如何排序 / 98
6.3.3 形成最终风险等级清单 / 99
本章小结:分级决定响应优先级 / 100
第7 章 修复(Respond):让 AI 重新采信正确信源 / 101
7.1 从分级进入修复:不同等级对应不同响应窗口 / 101
7.2 修复前:锁定错误答案、平台入口和信源缺口 / 102
7.2.1 固证建单:保存AI 当时的回答 / 102
7.2.2 查引用源:核实来源、时间与上下文 / 103
7.2.3 盘点信源缺口:AI 缺什么 / 104
7.2.4 统一内部口径:企业内部先达成一致 / 105
7.3 修复中:发布AI 可读内容、平台反馈与源头治理 / 105
7.3.1 GEO 信源补强:把正确事实写成AI 可读内容 / 106
7.3.2 平台反馈纠错:什么时候反馈,什么时候投诉 / 107
7.3.3 原始舆情源治理:不实、过时、污染与缺口 / 108
7.4 修复后:多入口复测与二次修复 / 109
本章小结:修复的关键,是让AI 重新采信正确信源 / 110
第8 章 防御(Defend):让AI 持续说对,把防御做成日常 / 111
8.1 AI 声誉防御需要长期运行 / 112
8.2 旧舆情与遗留风险进入持续治理 / 112
8.2.1 旧新闻、旧投诉、旧问答重新进入AI 答案 / 113
8.2.2 短期没有处理掉的风险进入遗留清单 / 113
8.2.3 难以清除的风险转向解释、替代和长期复测 / 114
8.2.4 长期负面标签重建解释框架 / 114
8.2.5 线下公关与线上信源同步推进 / 115
8.3 新增舆情进入发现、研判与处理闭环 / 116
8.3.1 新增舆情进入长期防御视野 / 116
8.3.2 舆情监测系统定期发现新风险 / 117
8.3.3 AI 舆情系统完成初筛、溯源与合规处理 / 117
8.3.4 新增风险进入分流处置机制 / 117
8.3.5 处理结果进入复测与回流 / 118
8.4 AI 内容供应链维护 / 118
8.5 正确信源持续更新,保持AI 可采信 / 119
8.5.1 核心内容资产长期维护 / 119
8.5.2 企业变化触发内容更新 / 120
8.5.3 正确信源同步到公开阵地 / 120
8.5.4 正确信源达到可访问、可引用、可验证标准 / 121
8.5.5 AI 答案验证正确信源是否生效 / 121
8.6 高压问题持续复测,防止AI 重新被带偏 / 121
8.6.1 固定信任、合规、采购、投资、招聘、竞品、安全问题 / 122
8.6.2 复测竞品舆情是否影响自身AI 声誉 / 123
8.7 复盘回流形成下一轮防御资产 / 124
8.8 把 AI 声誉防御纳入企业组织机制 / 125
本章小结:长期防御的核心,是让正确信源持续压过错误信号 / 126
实战与边界篇 GUARD 的行业应用与合规边界
第9 章 场景应用:不同风险状态下如何使用 GUARD / 128
9.1 风险存量决定 GUARD 的发力点 / 129
9.2 认知缺席型案例:云梦枕从推荐缺席到进入选型答案 / 130
9.2.1 企业痛点 / 130
9.2.2 问题来源 / 130
9.2.3 GUARD 发力点:体检 + 修复 + 防御 / 131
9.2.4 行业经验 / 132
9.3 旧信息复活型案例:明焰电器旧售后投诉被放大为“服务不稳定” / 132
9.3.1 企业痛点 / 132
9.3.2 问题来源 / 133
9.3.3 GUARD 发力点:溯源 + 修复 + 防御 / 133
9.3.4 行业经验 / 134
9.4 评价污染型案例:璃彩美妆如何把口碑、门店和经营信息分层处理 / 134
9.4.1 企业痛点 / 134
9.4.2 问题来源 / 135
9.4.3 GUARD 发力点:溯源 + 分级 + 修复 / 135
9.4.4 行业经验 / 136
9.5 高密度负面型案例:远承零售集团在长期负面信息中重建 AI 事实边界 / 136
9.5.1 企业痛点 / 136
9.5.2 问题来源 / 137
9.5.3 GUARD 发力点:体检 + 溯源 + 分级 + 修复 + 防御 / 137
9.5.4 行业经验 / 139
9.6 风险状态与行业场景对照表 / 140
9.7 企业适配的四个重心:厚度、速度、精度、边界 / 140
本章小结:强调不同风险状态决定GUARD 发力点 / 141
第10 章 合规边界:白帽GEO、操纵型GEO 与品牌解释权 / 142
10.1 白帽GEO:在真实、公开、可验证、可复测 的边界内修复AI 认知 / 142
10.1.1 白帽GEO 的四条底线 / 142
10.1.2 防御AI 误读,不能走向操纵型GEO / 143
10.1.3 操纵型GEO 为什么会成为企业信任陷阱 / 144
10.1.4 白帽GEO 与高风险GEO 操作的边界 / 144
10.2 企业纠错的边界:什么能改,什么只能解释 / 145
10.2.1 错误事实可以纠正 / 146
10.2.2 过时信息需要补充时间线 / 146
10.2.3 真实负面需要补充处理结果 / 146
10.2.4 片面评价需要样本校正 / 147
10.2.5 恶意造谣与AI 生成伪造内容,需要固证、投诉和依法处理 / 147
10.2.6 复合负面答案的优先级处理 / 147
10.3 守住AI 时代的品牌解释权 / 149
本章小结:品牌解释权的前提是真实 / 150
第11 章 从防御到资产:AI 声誉治理的商业价值转化 / 151
11.1 从GUARD 防御到经营价值 / 151
11.1.1 GUARD 构筑AI 时代的信任底盘 / 152
11.1.2 AI 声誉治理开始嵌入经营现场 / 152
11.1.3 从被动修复到主动经营AI 声誉 / 152
11.2 AI 声誉风险如何进入经营结果 / 153
11.2.1 获客阻力:用户在咨询前被AI 劝退 / 153
11.2.2 成交阻力:客户带着AI 疑问进入销售流程 / 154
11.2.3 定价阻力:品牌溢价被AI 的平庸描述压缩 / 154
11.2.4 续约阻力:老客户被旧信息重新影响 / 154
11.2.5 投标与融资阻力:AI 错误进入尽调和合作评估 / 155
11.2.6 招聘阻力:候选人通过AI 形成雇主印象 / 155
11.2.7 组织效率阻力:销售、客服、公关反复解释同一问题 / 155
11.3 AI 声誉治理的价值观察框架 / 156
11.4 把GUARD 成果嵌入企业经营流程 / 158
11.4.1 管理层:把AI 声誉纳入经营看板 / 159
11.4.2 销售与客户成功:把正确AI 答案转化为销售支持和续约信任 / 160
11.4.3 投标、融资与招商:建立数字信任资产清单 / 160
11.4.4 产品与品牌:把AI 负面反馈转化为改进线索和公开信源 / 160
11.4.5 员工与法务:把雇主品牌和高风险AI 错误纳入治理机制 / 161
11.5 从声誉资产到AI 时代的数字信任资产 / 161
11.6 从风险防御到信任增长 / 163
本章小结:让GUARD 成为AI 时代的数字信任资产系统 / 164
附录 / 165
附录A AI 声誉监测与复测总表 / 165
A.1 AI 声誉监测问题库 / 165
A.2 AI 声誉风险分级参考表 / 166
附录B AI 平台错误答案响应修复工具包 / 166
B.1 AI 错误答案固证清单 / 166
B.2 平台纠错材料模板 / 167
B.3 AI 可读纠正内容模板 / 168
附录C AI 声誉风险排查与合规检查清单 / 171
C.1 AI 声誉高压问题库 / 171
C.2 AI 声誉风险识别清单 / 173
C.3 白帽GEO 合规检查清单 / 174
附录D 参考资料与数据来源 / 175
后记 致每一位正在定义AI 品牌的读者 / 179
文摘▼
本书聚焦生成式AI时代企业声誉风险的全新演变。随着大模型、AI搜索及内容平台AI摘要逐步渗透用户决策全链路,企业面临的舆情环境已发生根本性转变——不再局限于传统的“网络舆论评价”,更延伸至AI对企业信息的总结、对比、引用与推荐环节。旧闻旧事、片面评价、错误事实和模型幻觉,都可能被AI重新整合为看似客观中立的答案,进而直接影响用户的购买决策、合作意向、投标结果、融资进程、人才招聘,以及媒体舆论导向,给企业声誉带来隐蔽且深远的冲击。
针对这一全新挑战,本书创新性提出GUARD品牌AI声誉防御模型,涵盖 Gauge(声誉体检)、Uncover(风险溯源)、Assess(风险分级)、Respond(响应修复)、Defend(长期防御)五大核心模块。该模型助力企业精准识别AI生成答案中的潜在风险,深度挖掘风险背后的引用源与事实根源,通过构建权威正确信源、完善平台反馈机制、治理原始舆情源头及开展持续复测,推动AI重新建立对企业的准确认知,筑牢AI时代企业声誉防线。
本书专为企业负责人、公关负责人、品牌负责人、市场负责人、内容运营人员、舆情管理人员及GEO从业者量身打造,兼顾理论深度与实操价值。书中配套提供的AI声誉体检表、错误答案固证清单、平台纠错材料模板、负面查询词包及白帽GEO服务商审查清单,可直接落地应用,为企业构建全流程、可复用的AI声誉管理体系提供坚实的实战支撑。