 正版
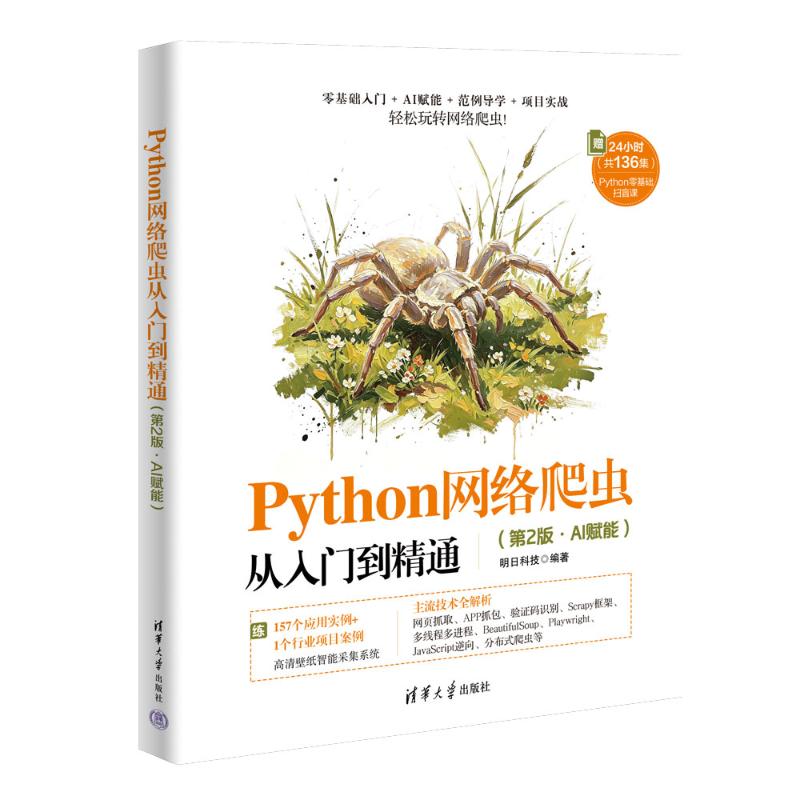
Python网络爬虫从入门到精通
- 书名
- Python网络爬虫从入门到精通
- 作者
- 明日科技 著
- 出版社
- 清华大学出版社
- 出版时间
- 2026-10-01
- ISBN
- 9787302728641
- 货号
- 1204668633
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- Python网络爬虫从入门到精通
- 作者
- 明日科技 著
- 出版社
- 清华大学出版社
- 出版时间
- 2026-10-01
- ISBN
- 9787302728641
- 货号
- 1204668633
- 品相
- 全新
- 分类
- 当代·工业
作者简介▼
明日科技是一家专业从事软件开发、教育培训及软件开发教育资源整合的高科技公司。其编写的教材注重选取软件开发中必需、常用内容,兼顾易学性与知识拓展性,深受读者喜爱;多次荣获 “全行业优秀畅销品种 全国高校出版社优秀畅销书 ” 等奖项,多个品种长期位居同类图书销售排行榜前列。
目录▼
目录
第1篇 基础知识
第1章 初识网络爬虫 2
1.1 网络爬虫基础 2
1.1.1 概述 2
1.1.2 网络爬虫的分类 2
1.1.3 网络爬虫的基本原理 3
1.1.4 网络爬虫法律与伦理道德 3
1.2 搭建网络爬虫开发环境 4
1.2.1 安装 Anaconda 4
1.2.2 PyCharm 的下载与安装 7
1.2.3 配置 PyCharm 9
1.2.4 测试 PyCharm 10
1.2.5 在 PyCharm 中集成 AI 工具 11
1.3 实践与练习 13
第2章 Web 前端基础 14
2.1 HTTP 基本原理 14
2.1.1 HTTP 14
2.1.2 HTTP 与 Web 服务器 14
2.1.3 浏览器中的请求和响应 15
2.1.4 AI 辅助 HTTP 请求与响应分析 16
2.2 HTML 17
2.2.1 什么是 HTML 17
2.2.2 标签、元素、结构概述 17
2.2.3 HTML 的基本标签 19
2.3 CSS 20
2.3.1 CSS 概述 20
2.3.2 属性选择器 20
2.3.3 类和 ID 选择器 21
2.4 JavaScript 动态脚本语言 21
2.4.1 JavaScript 概述 22
2.4.2 JavaScript 嵌入与交互 22
2.4.3 AI 辅助 JavaScript 开发与调试 24
2.5 Web 浏览器的使用 25
2.5.1 浏览器开发人员工具结构 25
2.5.2 元素检查与修改 26
2.5.3 网络请求分析 28
2.5.4 设备模拟与调试 29
2.5.5 JS 调试台使用 30
2.6 实践与练习 32
第3章 Python 内置网络库的使用 33
3.1 urllib 简介 33
3.1.1 urllib 模块组成 33
3.1.2 AI 辅助 urllib 快速入门 33
3.2 使用 urlopen方法发送请求 34
3.2.1 发送 GET 请求 34
3.2.2 发送 POST 请求 35
3.2.3 设置网络超时 36
3.2.4 借助 AI 调试失败请求 36
3.3 复杂的网络请求 37
3.3.1 设置请求头 38
3.3.2 Cookie 的获取与设置 39
3.3.3 设置代理 IP 44
3.4 异常处理 44
3.4.1 urllib 异常类核心功能 44
3.4.2 借助 AI 定位与修复异常 46
3.5 解析链接 47
3.5.1 拆分 URL 47
3.5.2 组合 URL 48
3.5.3 连接 URL 49
3.5.4 URL 的编码与解码 50
3.5.5 URL 参数的转换 51
3.6 实践与练习 52
第4章 常用第三方网络库的使用 53
4.1 urllib3 库的使用 53
4.1.1 基本请求发送 53
4.1.2 复杂请求发送 56
4.1.3 上传文件 58
4.2 requests 库的使用 59
4.2.1 基本网络请求 60
4.2.2 复杂网络请求 63
4.2.3 代理服务 67
4.2.4 AI 辅助 requests 高效开发 70
4.3 httpx 库的使用 72
4.3.1 同步请求 72
4.3.2 异步请求 74
4.3.3 代理配置 75
4.3.4 使用 AI 生成 httpx 异步代码 77
4.4 实践与练习 77
第5章 高级网络请求模块 79
5.1 Requests-Cache 模块 79
5.1.1 安装与测试 79
5.1.2 缓存应用 79
5.2 Requests-HTML 模块 82
5.2.1 发送网络请求 82
5.2.2 数据的提取 83
5.2.3 实战应用:获取电影信息 86
5.2.4 利用 AI 开发选择器生成实例 88
5.3 实践与练习 90
第2篇 核心技术
第6章 正则表达式与爬虫 92
6.1 正则表达式基础 92
6.1.1 正则表达式核心语法 92
6.1.2 AI 辅助生成正则表达式 95
6.1.3 在 Python 中使用正则表达式语法 95
6.2 使用 match匹配爬取内容 95
6.2.1 匹配字符串是否以指定字符串开头 96
6.2.2 匹配以任意字符开头的字符串 97
6.2.3 匹配多个字符串 97
6.2.4 获取部分内容 98
6.2.5 匹配指定首尾的字符串 98
6.3 使用 search匹配爬取内容 98
6.3.1 获取第一匹配值 99
6.3.2 可选匹配 99
6.3.3 匹配字符串边界 100
6.4 使用 findall匹配爬取内容 100
6.4.1 匹配所有指定字符开头的字符串 100
6.4.2 贪婪匹配 101
6.4.3 非贪婪匹配 101
6.5 数据爬取中的字符串处理 102
6.5.1 替换字符串 102
6.5.2 分割字符串 104
6.6 案例:爬取视频 104
6.6.1 查找视频页面 104
6.6.2 分析视频地址 105
6.6.3 实现视频下载 106
6.6.4 AI 优化案例 106
6.7 实践与练习 107
第7章 XPath 解析 108
7.1 XPath 概述 108
7.2 XPath 的解析操作 108
7.2.1 解析 HTML 109
7.2.2 获取所有节点 110
7.2.3 获取子节点 112
7.2.4 获取父节点 113
7.2.5 获取文本 114
7.2.6 属性匹配 114
7.2.7 获取属性 116
7.2.8 按序获取 117
7.2.9 节点轴获取 118
7.3 案例:爬取豆瓣电影 Top 250 119
7.3.1 分析请求地址 119
7.3.2 分析信息位置 120
7.3.3 爬虫代码的实现 121
7.3.4 AI 辅助 XPath 优化与反爬处理 122
7.4 实践与练习 123
第8章 使用 BeautifulSoup 解析数据 125
8.1 BeautifulSoup 基础 125
8.2 获取节点内容 127
8.2.1 获取节点对应的代码 127
8.2.2 获取节点属性 128
8.2.3 获取节点包含的文本内容 129
8.2.4 嵌套获取节点内容 129
8.2.5 关联获取 130
8.2.6 AI 辅助复杂节点关联获取 134
8.3 获取内容 135
8.3.1 find_all获取所有符合条件的内容 135
8.3.2 find获取第一个匹配的节点内容 138
8.3.3 其他方法 138
8.4 CSS 选择器的使用 139
8.5 BeautifulSoup 与 XPath 的使用场景 141
8.6 实践与练习 141
第9章 爬取动态渲染的信息 143
9.1 Ajax 数据的爬取 143
9.1.1 分析网络请求 143
9.1.2 模拟请求 144
9.1.3 处理响应内容 145
9.2 使用 Selenium 爬取动态加载的信息 147
9.2.1 安装 Selenium 模块 147
9.2.2 下载浏览器驱动 148
9.2.3 Selenium 模块的使用 148
9.2.4 Selenium 模块的常用方法 153
9.2.5 AI 辅助 Selenium 元素定位与调试 154
9.3 Playwright 的使用 154
9.3.1 安装 Playwright 模块 155
9.3.2 Playwright 的基本使用 155
9.3.3 多窗口或选项卡处理 156
9.3.4 移动端仿真测试 157
9.3.5 常用操作方法 157
9.4 JavaScript 逆向基础 160
9.4.1 Python 模拟执行 JavaScript 160
9.4.2 浏览器中 JavaScript 的模拟执行 160
9.4.3 AST 技术应用 161
9.4.4 WebAssembly 动态调试 162
9.4.5 JavaScript 逆向技巧总结 163
9.4.6 AI 处理混淆的 JS 代码 163
9.5 实践与练习 164
第10章 多线程与多进程爬虫 165
10.1 线程 165
10.1.1 创建线程 165
10.1.2 线程间通信 167
10.1.3 互斥锁 168
10.1.4 使用队列在线程间通信 170
10.1.5 多线程在爬虫中的应用 171
10.2 进程 174
10.2.1 创建进程的常用方式 174
10.2.2 进程间通信 180
10.2.3 队列简介 181
10.2.4 多进程队列的使用 182
10.2.5 使用队列在进程间通信 183
10.2.6 多进程在爬虫中的应用 184
10.3 AI 对比线程与进程 189
10.4 实践与练习 189
第11章 爬虫数据存储 191
11.1 文件的存储 191
11.1.1 存储 TXT 文本文件 191
11.1.2 存储 JSON 文件(AI 优化) 193
11.1.3 存储 CSV 文件 196
11.1.4 存储 Excel 文件 197
11.2 SQLite 数据库 198
11.2.1 创建数据库文件 198
11.2.2 操作 SQLite 199
11.3 MySQL 数据库 200
11.3.1 下载与安装 MySQL 200
11.3.2 安装 PyMySQL 201
11.3.3 连接数据库 201
11.3.4 创建数据表 202
11.3.5 操作 MySQL 数据表 203
11.3.6 借助 AI 排查 MySQL 连接错误 204
11.4 实践与练习 205
第3篇 高级应用
第12章 数据可视化 208
12.1 Matplotlib 概述 208
12.1.1 Matplotlib 简介 208
12.1.2 安装并使用 Matplotlib 210
12.2 Matplotlib 图表的常用设置 210
12.2.1 基本绘图 plot函数 210
12.2.2 设置画布 213
12.2.3 设置坐标轴 214
12.2.4 添加文本标签 217
12.2.5 设置标题和图例 218
12.2.6 添加注释 220
12.3 利用图表分析爬取的数据 221
12.3.1 折线图分析期中考试成绩 221
12.3.2 柱形图分析图书销售数据 222
12.3.3 饼形图分析各省销售占比情况 224
12.3.4 AI 辅助图表选型 229
12.4 Pyecharts 图表应用 230
12.4.1 Pyecharts 图表组成 230
12.4.2 Pyecharts 图表分析对比手机数据 231
12.5 案例:可视化二手房数据查询系统 233
12.6 实践与练习 240
第13章 App 抓包工具 241
13.1 Charles 工具的下载与安装 241
13.2 SSL 证书的安装 243
13.2.1 安装计算机端证书 243
13.2.2 设置代理 246
13.2.3 配置网络 247
13.2.4 安装手机端证书 249
13.3 实践与练习 251
第14章 识别验证码 252
14.1 字符验证码 252
14.1.1 搭建 OCR 环境 252
14.1.2 下载字符验证码图片 254
14.1.3 识别字符验证码 255
14.2 第三方验证码识别 257
14.3 滑动拼图验证码 260
14.3.1 Python 结合 Selenium 破解滑动拼图验证码 260
14.3.2 Playwright 动作链破解滑动拼图验证码 262
14.3.3 借助 AI 生成逼真滑动轨迹 266
14.4 实践与练习 267
第15章 Scrapy 爬虫框架 268
15.1 Scrapy 爬虫框架基础 268
15.2 搭建 Scrapy 爬虫框架 269
15.2.1 使用 Anaconda 安装 Scrapy 269
15.2.2 在 Windows 系统中配置Scrapy 270
15.3 Scrapy 的基本应用 271
15.3.1 创建 Scrapy 项目 271
15.3.2 创建爬虫 272
15.3.3 获取数据 274
15.3.4 将爬取的数据保存为多种格式的文件 276
15.3.5 AI 辅助生成爬虫代码 277
15.4 编写 Item Pipeline 278
15.4.1 项目管道的核心方法 278
15.4.2 将信息存储至数据库 278
15.5 自定义中间件 283
15.5.1 设置随机请求头 283
15.5.2 设置 Cookies 286
15.5.3 设置代理 IP 288
15.5.4 借助 AI 生成智能代理中间件 290
15.6 文件下载 291
15.7 实践与练习 293
第16章 Scrapy-Redis 分布式爬虫 295
16.1 Redis 数据库基础 295
16.1.1 安装 Redis 数据库 295
16.1.2 Redis Insight 可视化管理工具 296
16.1.3 Python 操作 Redis 数据库 296
16.2 Scrapy-Redis 模块 298
16.3 分布式爬取新闻数据 299
16.3.1 分析请求地址 300
16.3.2 创建随机请求头 300
16.3.3 创建数据对象 301
16.3.4 将爬取的数据写入 MySQL数据库 301
16.3.5 数据的爬取与爬虫项目启动 302
16.3.6 编写配置文件 304
16.3.7 启动分布式爬虫项目 304
16.4 分布式爬虫的部署 308
16.4.1 分布式爬虫架构 308
16.4.2 部署分布式爬虫 309
16.4.3 AI 辅助生成部署脚本 312
16.4.4 实战应用:分布式爬取诗词 314
16.5 实践与练习 322
第4篇 项目实战
第17章 高清壁纸智能采集系统 324
17.1 需求分析 324
17.2 系统设计 324
17.2.1 系统功能结构 324
17.2.2 系统业务流程 325
17.2.3 系统预览 325
17.3 系统开发准备 325
17.4 主窗体的 UI 设计 326
17.4.1 主窗体的布局 326
17.4.2 主窗体显示效果 327
17.5 系统实现 328
17.5.1 模块导入 328
17.5.2 多线程爬取并保存高清壁纸 329
17.5.3 在 PyQt5 窗体中调用爬虫方法 332
17.5.4 使用列表显示爬取的所有高清壁纸名称 333
17.5.5 在 PyQt5 窗体中查看爬取的高清壁纸 335
17.6 AI 辅助优化项目 336
17.6.1 AI 智能校验图片链接有效性 336
17.6.2 AI 图片内容分类与去重 337
17.6.3 AI 解决 UI 卡顿问题 340
17.7 项目运行 341
17.8 项目总结 342
文摘▼
《Python网络爬虫从入门到精通(第2版 · AI赋能)》从初学者角度出发,通过通俗易懂的语言、丰富多彩的实例,深度融合 AI 编程,详细介绍了使用 Python 进行网络爬虫开发需要掌握的技术。本书分为 17 章,内容包括初识网络爬虫、Web 前端基础、Python 内置网络库的使用、常用第三方网络库的使用、高级网络请求模块、正则表达式与爬虫、XPath 解析、使用 BeautifulSoup 解析数据、爬取动态渲染的信息、多线程与多进程爬虫、爬虫数据存储、数据可视化、App 抓包工具、识别验证码、Scrapy 爬虫框架、Scrapy-Redis分布式爬虫,以及高清壁纸智能采集系统项目开发。书中所有知识都结合具体实例进行介绍,涉及的程序代码给出了详细的注释,读者可轻松领会网络爬虫程序开发的精髓,快速提高开发技能。