 正版
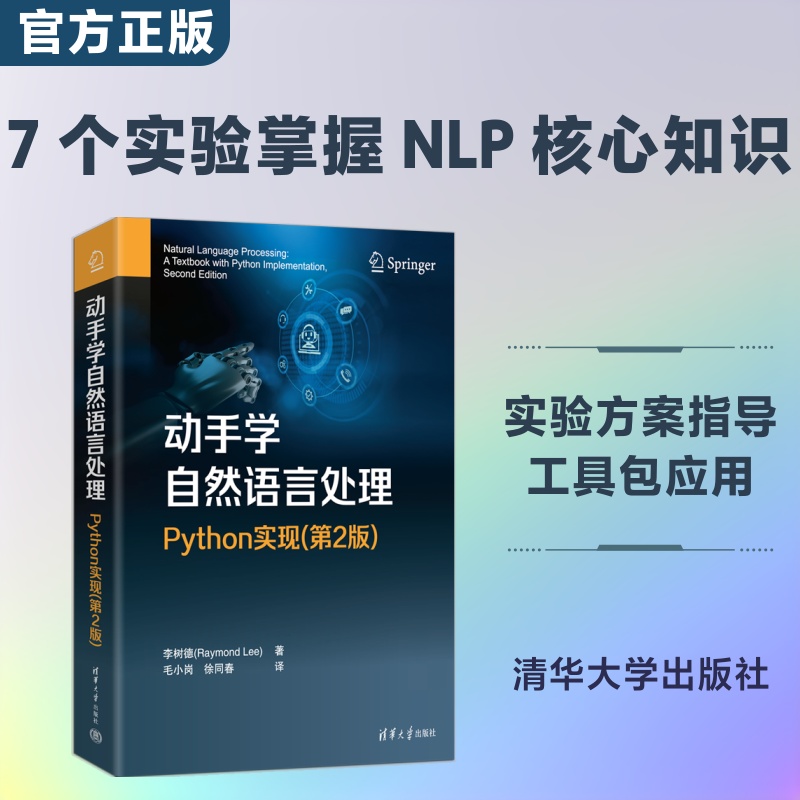
动手学自然语言处理:Python实现(第2版)
- 书名
- 动手学自然语言处理:Python实现(第2版)
- 作者
- 李树德 著 毛小岗,徐同春 译
- 出版社
- 清华大学出版社
- 出版时间
- 2026-10-01
- ISBN
- 9787302727354
- 货号
- 1204667604
- 品相
- 全新
- 分类
- 涉及近代·工业
- 书名
- 动手学自然语言处理:Python实现(第2版)
- 作者
- 李树德 著 毛小岗,徐同春 译
- 出版社
- 清华大学出版社
- 出版时间
- 2026-10-01
- ISBN
- 9787302727354
- 货号
- 1204667604
- 品相
- 全新
- 分类
- 涉及近代·工业
作者简介▼
毛小岗,博士,首都经济贸易大学讲师。他是数据科学和人工智能领域的研究者和爱好者,参与过多项企业和政府主导的数据分析课题并做了大量相关工作。毛博士在大学里主讲“Python文本数据挖掘实战”“商务数据分析”和“机器学习实战与Kaggle竞赛实训”等多门数据分析课程,教学功底扎实。
徐同春,首都经济贸易大学工商管理学院研究生,研究方向为公司治理与公司金融,专注数据科学在企业管理和商业分析中的运用。
目录▼
第I部分概念与技术
第1章自然语言处理简介2
1.1引言2
1.2人类语言与智能3
1.3人类语言的语言层级5
1.4人类语言的歧义6
1.5自然语言处理简史7
1.5.1第一阶段:机器翻译(20世纪60年代以前)7
1.5.2第二阶段:早期人工智能在自然语言处理中的应用(20世纪60年代至70年代)7
1.5.3第三阶段:自然语言处理的语法逻辑阶段(20世纪70年代至80年代)8
1.5.4第四阶段:人工智能与机器学习(20世纪80年代至2000年代)8
1.5.5第五阶段:BERT、Transformer、ChatGPT与大型语言模型的兴起(2000年代–至今)8
1.6自然语言处理与人工智能9
1.7自然语言处理的主要组成部分10
1.8自然语言理解11
1.8.1语音识别12
1.8.2句法分析12
1.8.3语义分析12
1.8.4语用分析12
1.9自然语言处理的潜在应用12
1.9.1机器翻译13
1.9.2信息提取13
1.9.3信息检索14
1.9.4情感分析14
1.9.5问答型聊天机器人14
第2章N元语言模型16
2.1引言16
2.2N元语言模型18
2.2.1基本的NLP术语20
2.2.2语言建模与链式规则21
2.3马尔可夫链在N元模型中的应用23
2.4实例探究:《福尔摩斯探案集》24
2.5N元模型中的香农方法28
2.6语言模型评估与平滑技术31
2.6.1困惑度31
2.6.2外部评估方法32
2.6.3零计数问题33
2.6.4平滑技术33
2.6.5拉普拉斯(加1)平滑33
2.6.6加k平滑35
2.6.7回退和插值平滑36
2.6.8古德-图灵平滑37
2.7练习题37
第3章词性标注39
3.1词性的概念39
3.2词性标注40
3.2.1语言学中词性标注的概念40
3.2.2自然语言处理中词性标注的概念40
3.2.3宾州树库项目中使用的词性标签41
3.2.4自然语言处理中词性的重要性43
3.3自然语言理解中的主要组成部分44
3.3.1计算语言学和词性标注45
3.3.2词性和语义含义45
3.3.3形态与句法定义的词性标注46
3.4英语中的九大词性46
3.4.1英语词类47
3.4.2介词的定义48
3.4.3连词的定义49
3.4.4代词的定义50
3.4.5动词的定义51
3.5词性标注集的不同类型52
3.5.1标注集的概念52
3.5.2词性标注的歧义性53
3.5.3使用知识进行词性标注54
3.6词性标注的方法54
3.6.1基于规则的词性标注方法54
3.6.2基于规则的词性标注示例55
3.6.3基于概率的词性标注示例56
3.6.4使用Brill标注器的混合方法进行词性标注57
3.6.5基于转换的学习的概念57
3.6.6混合词性标注:Brill标注器58
3.6.7学习Brill标注器的转换58
3.7词性标注器的评估59
3.8练习题60
第4章句法分析61
4.1引言和目的61
4.2句法分析介绍62
4.2.1句法的概念62
4.2.2句法规则62
4.2.3常见的句法模式62
4.2.4句法分析在自然语言处理中的重要性63
4.3句子中的成分类型64
4.3.1成分的概念64
4.3.2成分的种类65
4.3.3名词短语65
4.3.4动词短语66
4.3.5简单成分的复杂性67
4.3.6动词短语的子类划分68
4.3.7词汇在解析中的作用69
4.3.8语法规则中的递归70
4.4上下文无关语法70
4.4.1上下文无关语言的概念70
4.4.2上下文无关语法的概念71
4.4.3上下文无关语法的主要组成部分71
4.4.4使用上下文无关语法的推导72
4.5上下文无关语法解析73
4.5.1形态学解析73
4.5.2音位学解析73
4.5.3句法解析74
4.5.4解析作为一种树搜索74
4.5.5英语片段的上下文无关语法74
4.5.6“PlaythePiano”的上下文无关语法的解析树74
4.5.7自顶向下解析器75
4.5.8自底向上解析器76
4.5.9解析控制77
4.5.10自顶向下与自底向上解析的优缺点78
4.6词汇化和概率解析78
4.6.1在解析中使用概率的原因78
4.6.2解析中的语义79
4.6.3概率上下文无关语法的概念80
4.6.4概率上下文无关语法的简单示例80
4.6.5使用概率进行语言建模83
4.6.6概率上下文无关语法的局限性83
4.6.7解决方案:词汇化解析84
4.7练习题86
第5章语义表示87
5.1引言87
5.2语义的概念87
5.3语义表示88
5.4语义处理89
5.5常见的语义表示方法89
5.5.1一阶谓词演算90
5.5.2语义网络90
5.5.3概念依赖图90
5.5.4基于框架的表达91
5.6语义表示的要求92
5.6.1可验证性92
5.6.2歧义性92
5.6.3含糊性92
5.6.4规范形式93
5.7推理94
5.7.1推理的概念94
5.7.2使用一阶谓词逻辑进行推理的例子94
5.8Fillmore的普遍案例理论95
5.8.1Fillmore的普遍案例理论的概念95
5.8.2Fillmore理论中的主要案例角色96
5.8.3案例角色分析中的复杂性97
5.9一阶谓词逻辑98
5.9.1一阶谓词逻辑表示方案98
5.9.2一阶谓词逻辑的主要元素98
5.9.3一阶谓词逻辑的谓词-参数结构100
5.9.4一阶谓词逻辑中的语义表示问题101
5.9.5使用一阶谓词逻辑进行推理101
5.10练习题103
第6章语义分析104
6.1引言104
6.1.1语义分析的概念104
6.1.2语义分析在自然语言处理中的重要性104
6.1.3人类在语义分析方面的优势105
6.2词汇语义分析与组合语义分析105
6.2.1词汇语义分析的概念105
6.2.2组合语义分析的概念106
6.3单词意义和关系107
6.3.1单词意义的概念107
6.3.2词汇语义的类型107
6.4词义消歧111
6.4.1词义消歧的概念111
6.4.2词义消歧的难点112
6.4.3词义消歧的方法113
6.5WordNet与在线词库114
6.5.1WordNet的概念114
6.5.2Synsets的概念114
6.5.3WordNet的知识结构115
6.5.4WordNet中捕获的主要词汇关系116
6.5.5WordNet和词典的应用117
6.6其他在线词库:MeSH117
6.6.1MeSH的概念117
6.6.2MeSH本体的用途118
6.7词相似性和词库方法118
6.7.1引言118
6.7.2基于路径的相似性119
6.7.3基于路径的相似性问题120
6.7.4信息内容相似性120
6.7.5Resnik方法122
6.7.6DekangLin方法122
6.7.7扩展的Lesk算法123
6.8分布式相似性123
6.8.1分布式意义模型123
6.8.2词向量123
6.8.3词条-文档矩阵124
6.8.4点互信息125
6.8.5计算词条-上下文矩阵上的正点互信息的例子126
6.8.6加权点互信息技术127
6.8.7点互信息计算中的k平滑128
6.8.8上下文和词相似性测量129
6.8.9相似性评估131
6.9练习题131
第7章语用分析133
7.1引言133
7.2篇章现象133
7.2.1共指消解134
7.2.2共指消解的重要性134
7.2.3一致性与共指135
7.2.4共指关系的重要性136
7.2.5基于实体的一致性137
7.3篇章分割137
7.3.1篇章分割的概念137
7.3.2无监督篇章分割138
7.3.3Hearst的TextTiling方法138
7.3.4TextTiling算法140
7.3.5有监督篇章分割140
7.4篇章连贯性141
7.4.1文本的连贯性141
7.4.2连贯关系的概念142
7.4.3连贯关系的类型142
7.4.4篇章连贯性的层次结构143
7.4.5指称表达式的类型144
7.4.6筛选潜在指代对象的特征144
7.4.7代词解释中的偏好145
7.5共指消解算法146
7.5.1引言146
7.5.2Hobbs算法146
7.5.3中心算法148
7.5.4机器学习方法151
7.6评估153
7.7练习题153
第8章迁移学习和Transformer技术155
8.1迁移学习的概念155
8.2迁移学习的目的156
8.3迁移学习的解决方案157
8.4循环神经网络159
8.4.1循环神经网络的概念159
8.4.2循环神经网络的作用159
8.4.3循环神经网络体系结构160
8.4.4长短期记忆网络162
8.4.5门循环单元164
8.4.6双向循环神经网络165
8.5Transformer技术166
8.5.1Transformer的概念166
8.5.2Transformer架构167
8.5.3深入理解编码器168
8.6BERT170
8.6.1BERT的概念170
8.6.2BERT的架构170
8.6.3BERT的训练171
8.7其他相关的Transformer技术172
8.7.1Transformer-XL172
8.7.2ALBERT173
8.8练习题173
第9章主要的自然语言处理应用174
9.1引言174
9.2信息检索系统174
9.2.1信息检索系统简介174
9.2.2向量空间模型在信息检索中的应用175
9.2.3信息检索中的术语分布模型179
9.2.4潜在语义索引在信息检索中的应用181
9.2.5信息检索中的话语分割184
9.3文本摘要系统185
9.3.1文本摘要系统简介185
9.3.2文本摘要数据集187
9.3.3文本摘要系统类型187
9.3.4查询式摘要系统与通用摘要系统188
9.3.5单文档与多文档摘要190
9.3.6现代文本摘要系统191
9.4问答系统196
9.4.1QA系统和人工智能196
9.4.2工业级问答系统概述200
9.5练习题206
第10章大语言模型与生成式人工智能207
10.1大语言模型与生成式人工智能简介207
10.1.1什么是大语言模型207
10.1.2生成式人工智能概述208
10.1.3大语言模型与生成式人工智能的交汇209
10.1.4大语言模型在现代人工智能中的重要性210
10.2大语言模型的基础211
10.2.1神经网络架构211
10.2.2注意力机制212
10.2.3Transformer架构212
10.2.4模型规模化:从BERT到GPT214
10.3大语言模型领域的主要参与者215
10.3.1OpenAI的ChatGPT(当前版本:GPT-4)215
10.3.2GoogleDeepMind的Pathways语言模型(PaLM,当前版本为PaLM2)216
10.3.3Meta的大语言模型(LLaMA,当前版本为LLaMA2)217
10.3.4Anthropic的Claude(当前版本为Claude2)218
10.3.5百度的ERNIE3.0Titan219
10.4大语言模型在生成式人工智能中的应用220
10.4.1创意写作与内容生成220
10.4.2语言翻译221
10.4.3对话式人工智能与聊天机器人222
10.4.4文本摘要与内容策展224
10.5伦理考量与挑战225
10.5.1偏见的检测与缓解225
10.5.2隐私与数据安全226
10.5.3错误信息的传播226
10.5.4大语言模型部署的伦理指南227
10.6未来展望与研究方向228
10.6.1大语言模型与生成式人工智能的当前发展趋势228
10.6.2人工智能创造力的未来230
10.6.3大语言模型在人工智能伦理中的作用230
10.6.4未来发展方向:研究与开发231
10.7练习题233
第II部分使用Python实现的自然语言处理实验教程(14小时)
第11章实验1:自然语言工具包使用基础(第1-2小时)236
11.1引言236
11.2什么是NLTK238
11.3使用NLTK进行简单的文本分词示例238
11.4NLTK的安装239
11.5为什么使用Python进行自然语言处理241
11.6NLTK在基础文本处理中的应用242
11.7使用NLTK进行简单文本分析244
11.8使用词汇离散图进行文本分析247
11.8.1词汇离散图的概念247
11.8.2基于《理智与情感》文本的词汇离散图分析248
11.8.3基于就职演说语料库文本的历时词汇离散图分析248
11.9使用NLTK进行自然语言处理分词操作249
11.9.1什么是自然语言处理中的分词249
11.9.2tokenize与split的区别250
11.9.3统计不同的词元251
11.9.4词汇多样性253
11.10NLTK中的基本统计工具254
11.11使用累积模式绘制相同的频率分布图255
11.11.1罕见词257
11.11.2搭配词258
第12章实验2:使用自然语言工具包进行N-gram建模(第3-4小时)260
12.1引言260
12.2什么是N-gram261
12.3N-gram在自然语言处理中的应用261
12.4在NLTK中生成N-gram261
12.5生成N-gram统计信息264
12.6SpaCy在自然语言处理中的应用270
12.7如何安装spaCy271
12.8使用spaCy进行分词271
第13章实验3:基于自然语言工具包的词性标注(第5-6小时)278
13.1引言278
13.2重新审视NLTK中的分词技术279
13.3使用NLTK进行词干提取281
13.3.1词干提取概述281
13.3.2词干提取的意义282
13.3.3词干提取的实现方法282
13.4使用NLTK删除停用词285
13.4.1什么是停用词285
13.4.2NLTK停用词列表285
13.4.3示例文本实践286
13.4.4自定义停用词库286
13.5使用NLTK进行文本分析288
13.6与WordCloud集成290
13.7使用NLTK进行词性标注292
13.7.1什么是词性标注292
13.7.2通用词性标注集292
13.7.3PENNTreebank词性标注集(英文与中文版本)293
13.7.4词性标注的应用294
13.8使用NLTK创建自定义词性标注器297
第14章实验4:基于spaCy的语义分析与词向量(第7-8小时)303
14.1引言303
14.2词向量的概念304
14.3理解词向量304
14.4词向量初探306
14.5类比与向量运算309
14.6如何创建词向量310
14.7spaCy预训练词向量310
14.8语义分析中的相似度方法312
14.9使用spaCy的高级语义相似度方法315
14.9.1理解语义相似度315
14.9.2欧几里得距离315
14.9.3余弦距离与余弦相似度316
14.9.4使用语义相似度进行文本分类318
14.9.5提取关键短语319
14.9.6提取与比较命名实体320
第15章实验5:情感分析与文本分类(第9-10小时)323
15.1引言323
15.2使用spaCy和LSTM技术的文本分类324
15.3技术要求324
15.4文本分类概述325
15.4.1什么是文本分类325
15.4.2作为AI应用的文本分类326
15.5使用spaCyNLP流水线的文本分类器327
15.5.1TextCategorizer类327
15.5.2为TextCategorizer格式化训练数据329
15.5.3系统训练331
15.5.4系统测试333
15.5.5针对多标签文本分类训练TextCategorizer333
15.6使用spaCy进行情感分析337
15.6.1IMDB大型影评数据集337
15.6.2数据集探索337
15.6.3训练TextClassifier340
15.7人工神经网络概述342
15.8TensorFlow与Keras概述343
15.9使用LSTM技术进行序列建模343
15.10Keras分词器在自然语言处理中的应用344
15.11基于LSTM的电影影评情感分析(使用Keras与spaCy)348
第16章实验6:使用spaCy与TensorFlow的Transformer模型(第11-12小时)355
16.1引言355
16.2技术要求356
16.3Transformer与迁移学习概述356
16.4为什么选择Transformer357
16.5BERT技术概述359
16.5.1BERT是什么359
16.5.2BERT架构360
16.5.3BERT输入格式362
16.5.4如何训练BERT363
16.6Transformer与TensorFlow364
16.6.1HuggingFace的Transformers库364
16.6.2使用BERT分词器366
16.6.3BERT中的词向量369
16.7使用BERT回顾文本分类370
16.8Transformer流水线技术374
16.8.1面向情感分析的Transformer流水线375
16.8.2面向问答系统的Transformer流水线375
16.9Transformer与spaCy376
第17章实验7:基于TensorFlow与Transformer技术构建聊天机器人(第13-14小时)380
17.1引言380
17.2技术要求381
17.3AI聊天机器人概述381
17.3.1聊天机器人是什么381
17.3.2聊天机器人的唤醒词382
17.3.3聊天机器人中的自然语言处理组件383
17.4使用TensorFlow与Transformer技术构建电影聊天机器人383
17.4.1聊天机器人数据集384
17.4.2电影对话预处理384
17.4.3电影对话的分词处理386
17.4.4过滤与填充过程386
17.4.5创建TensorFlow电影数据集对象387
17.4.6计算注意力学习权重388
17.4.7多头注意力机制389
17.4.8系统实现390
17.5相关研究405
文摘▼
本书系统讲解自然语言处理(NLP)领域的前沿技术与核心知识,涵盖基础理论、经典算法,以及AI聊天机器人、大语言模型、生成式人工智能等当下热门应用方向,帮助读者快速建立系统化的NLP知识框架。书中特别设计了7个由浅入深的NLP实验项目(合计14小时的实验内容),带领读者动手实践主流Python工具库,包括NLTK、spaCy、TensorFlow、Keras、Transformer与BERT。通过完整的案例实操,帮助读者真正吃透理论、练会代码、掌握实战能力。
本书旨在帮助读者夯实自然语言处理技术基础,熟练使用Python开发各类NLP应用,独立完成聊天机器人等实用项目。读者可借助书中配套的NLP工具包,搭建属于自己的NLP应用。
本书兼顾课堂教学与工程实操,既可作为高校相关专业本科生、研究生的NLP入门与进阶教材,也适合授课教师、助教作为课程讲义与实验指导用书。读者完成书中14小时的Python实验训练后,可系统掌握NLP与人工智能相关知识,能够面向不同应用场景,构建可落地的NLP应用系统。