 正版
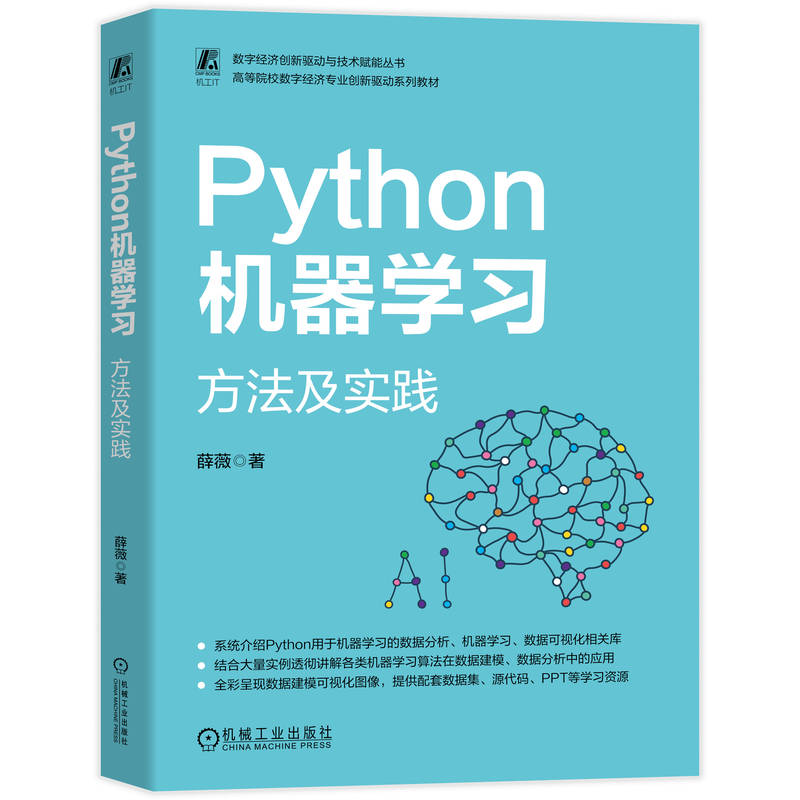
Python机器学习:方法及实践
- 书名
- Python机器学习:方法及实践
- 作者
- 薛薇 著
- 出版社
- 机械工业出版社
- 出版时间
- 2026-10-01
- ISBN
- 9787111819370
- 货号
- 1204588514
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- Python机器学习:方法及实践
- 作者
- 薛薇 著
- 出版社
- 机械工业出版社
- 出版时间
- 2026-10-01
- ISBN
- 9787111819370
- 货号
- 1204588514
- 品相
- 全新
- 分类
- 当代·工业
编辑推荐▼
系统介绍Python用于机器学习的数据分析、机器学习、数据可视化相关库
结合大量实例透彻讲解各类机器学习算法在数据建模、数据分析中的应用
全彩呈现数据建模可视化图像,提供配套数据集、源代码、PPT等学习资源
作者简介▼
薛薇博士,中国人民大学应用统计研究中心研究员,中国人民大学统计学院副教授。主要开设课程:机器学习,计量经济学,统计软件,统计学。研究方向:机器学习与深度学习算法研究和应用。
目录▼
前言
第1章 机器学习概述1
1.1 人工智能中的机器学习1
1.1.1 符号主义人工智能1
1.1.2 什么是机器学习2
1.1.3 机器学习助力人工智能发展3
1.2 机器学习中的大数据3
1.2.1 机器学习中的结构化数据3
1.2.2 机器学习中的半结构化数据5
1.2.3 机器学习中的非结构化数据6
1.3 机器学习的主要任务8
1.3.1 数据预测8
1.3.2 数据聚类10
1.3.3 其他任务10
1.4 机器学习的典型应用13
1.4.1 机器学习的典型行业应用13
1.4.2 机器学习在客户细分中的应用14
1.4.3 机器学习在客户流失分析中的
应用15
1.4.4 机器学习在营销响应分析中的
应用16
1.4.5 机器学习在交叉销售中的应用17
1.4.6 机器学习在欺诈甄别中的应用18
【本章总结】18
【本章习题】19
第2章 Python机器学习基础20
2.1 Python:机器学习的首选工具20
2.2 Python的集成开发环境:
Anaconda21
2.2.1 Anaconda概述21
2.2.2 Anaconda Prompt的使用22
2.2.3 Spyder的使用24
2.2.4 Jupyter Notebook的使用24
2.3 Python第三方包的引用26
2.4 NumPy使用示例26
2.4.1 NumPy数组的创建和访问26
2.4.2 NumPy的计算功能28
2.5 Pandas使用示例30
2.5.1 Pandas的序列和索引31
2.5.2 Pandas的数据框31
2.5.3 Pandas的数据加工处理33
2.6 NumPy和Pandas的综合应用:
空气质量监测数据的预处理和
基本分析35
2.6.1 空气质量监测数据的预处理35
2.6.2 空气质量监测数据的基本分析37
2.7 Matplotlib的综合应用:空气质量
监测数据的图形化展示39
2.7.1 AQI的时序变化特点39
2.7.2 AQI的分布特征及相关性分析41
2.8 Seaborn的综合应用:空气质量
监测数据的图形化展示43
2.8.1 探究各年PM2.5的统计分布
特征43
2.8.2 探究不同空气质量等级下PM2.5的
统计分布特征45
2.8.3 探究AQI和各种污染物浓度之间的
相关性46
【本章总结】48
【本章相关函数列表】48
【本章习题】54
第3章 数据预测与预测建模56
3.1 认识线性回归预测模型57
3.1.1 线性回归预测模型57
3.1.2 线性回归模型的几何理解57
3.1.3 回归预测模型的评价58
3.1.4 线性回归预测模型的Python应用
实践:PM2.5浓度预测58
3.2 认识线性分类预测模型64
3.2.1 线性分类预测模型:Logisitc回归和
Softmax回归64
3.2.2 线性分类模型的几何理解66
3.2.3 分类预测模型的评价68
3.2.4 Python应用实践:空气质量等级
预测70
3.3 从线性预测模型到非线性预测
模型77
3.4 预测模型的参数估计77
3.4.1 损失函数与有监督学习78
3.4.2 参数估计的策略79
3.5 预测模型的选择83
3.5.1 泛化误差的估计83
3.5.2 Python模拟和启示:理解泛化
误差86
3.5.3 预测模型的过拟合问题90
3.5.4 模型选择:偏差和方差91
【本章总结】94
【本章相关函数列表】94
【本章习题】95
第4章 数据预测建模:贝叶斯分
类器96
4.1 贝叶斯概率和贝叶斯法则96
4.1.1 贝叶斯概率96
4.1.2 贝叶斯法则97
4.2 朴素贝叶斯分类器97
4.2.1 从顾客行为分析看朴素贝叶斯
分类器97
4.2.2 Python模拟和启示:认识朴素贝叶斯
分类器的分类边界100
4.2.3 Python应用实践:空气质量等级
预测102
4.3 朴素贝叶斯分类器在文本分类中的
应用104
4.3.1 Python文本数据的预处理:文本
分词和量化计算105
4.3.2 Python文本描述性分析:词云图和
文本相似性109
4.3.3 Python文本分析综合应用:裁判
文书的要素提取110
*4.4 贝叶斯参数估计简介113
4.4.1 从科比投篮分析看贝叶斯参数
估计的基本思想113
4.4.2 共轭先验分布114
4.4.3 Python应用实践:科比投篮命中率的
研究117
【本章总结】118
【本章相关函数列表】119
【本章习题】119
第5章 数据预测建模:近邻分析120
5.1 近邻分析:K-近邻法120
5.1.1 距离:K-近邻法的近邻度量121
5.1.2 参数K:1-近邻法和K-近邻法122
5.2 回归预测中的K-近邻法122
5.2.1 Python模拟和启示:认识K-近邻
回归线123
5.2.2 Python模拟和启示:认识K-近邻
回归面125
5.3 分类预测中的K-近邻法127
5.3.1 基于1-近邻和K-近邻的分类127
5.3.2 Python模拟和启示:参数K和分类
边界128
5.4 基于观测相似性的加权K-近
邻法130
5.4.1 加权K-近邻法的权重130
5.4.2 Python模拟和启示:认识加权K-
近邻法的分类边界132
5.5 K-近邻法的Python应用实践133
5.5.1 空气质量等级的预测134
5.5.2 国产电视剧的大众评分预测135
*5.6 K-近邻法的适用性探讨137
【本章总结】138
【本章相关函数列表】139
【本章习题】139
第6章 数据预测建模:决策树140
6.1 决策树的基本概念140
6.1.1 什么是决策树140
6.1.2 决策树的深层含义141
6.2 回归预测中的决策树142
6.2.1 决策树的回归面143
6.2.2 Python模拟和启示:树深度对
回归面的影响143
6.3 分类预测中的决策树145
6.3.1 决策树的分类边界145
6.3.2 Python模拟和启示:树深度对分类
边界的影响146
6.4 决策树的生长和剪枝148
6.4.1 决策树的生长148
6.4.2 决策树的剪枝149
6.5 经典决策树算法:分类与回归树
CART150
6.5.1 CART的生长150
6.5.2 CART的后剪枝153
6.6 决策树的Python应用实践156
6.6.1 PM2.5浓度的预测156
6.6.2 空气质量等级的预测158
6.6.3 药物适用性研究159
*6.7 决策树的高方差性161
【本章总结】162
【本章相关函数列表】163
【本章习题】163
第7章 数据预测建模:支持向量机164
7.1 支持向量分类概述164
7.1.1 支持向量分类的基本思路165
7.1.2 支持向量分类的三种情况167
7.2 完全线性可分下的支持向量
分类168
7.2.1 完全线性可分下的超平面168
7.2.2 参数求解和分类预测170
7.2.3 Python模拟和启示:认识支持
向量172
7.3 广义线性可分下的支持向量
分类174
7.3.1 广义线性可分下的超平面175
7.3.2 广义线性可分下的误差惩罚和目标
函数176
7.3.3 Python模拟和启示:认识误差惩罚
参数C177
7.3.4 参数求解和分类预测178
7.4 线性不可分下的支持向量
分类179
7.4.1 线性不可分问题的一般解决
方式179
7.4.2 支持向量分类克服维灾难的
途径181
7.4.3 Python模拟和启示:认识核
函数183
*7.5 支持向量回归概述185
7.5.1 支持向量回归的基本思路185
7.5.2 支持向量回归的目标函数和约束
条件188
7.5.3 Python模拟和启示:认识 ? 189
7.6 支持向量机的Python应用实践:
老年人危险体位预警191
7.6.1 案例背景和数据说明191
7.6.2 Python实现192
【本章总结】196
【本章相关函数列表】196
【本章习题】197
第8章 数据预测建模:集成学习198
8.1 集成学习概述198
8.1.1 高方差问题的解决途径199
8.1.2 从弱模型到强模型的构建199
8.2 基于重抽样自举法的集成学习200
8.2.1 重抽样自举法200
8.2.2 袋装法的基本思想201
8.2.3 随机森林的基本思想202
8.2.4 Python应用实践:基于袋装法和
随机森林预测PM2.5浓度203
8.3 从弱模型到强模型的构建:
提升法206
8.3.1 提升法的基本思路207
8.3.2 Python模拟和启示:弱模型联合
成为强模型208
8.3.3 分类预测中的提升法:
AdaBoost.M1算法210
8.3.4 Python模拟和启示:认识
AdaBoost.M1算法中高权重样本214
8.3.5 回归预测中的提升法215
8.3.6 Python应用实践:基于AdaBoost
预测PM2.5浓度216
*8.3.7 提升法的推广算法218
8.4 梯度提升树221
8.4.1 梯度提升算法221
8.4.2 梯度提升回归树223
8.4.3 Python模拟和启示:认识梯度提升
回归树224
8.4.4 梯度提升分类树226
8.4.5 Python模拟和启示:认识梯度提升
分类树226
8.5 XGBoost算法228
8.5.1 XGBoost的目标函数228
8.5.2 目标函数的近似表达229
8.5.3 决策树的求解230
8.5.4 Python应用实践:基于XGBoost
预测空气质量等级231
【本章总结】234
【本章相关函数列表】235
【本章习题】235
第9章 数据预测建模:人工神经
网络237
9.1 人工神经网络的基本概念238
9.1.1 人工神经网络的基本构成238
9.1.2 人工神经网络节点的功能239
9.2 感知机网络240
9.2.1 感知机网络中的节点240
9.2.2 感知机节点中的加法器241
9.2.3 感知机节点中的激活函数242
9.2.4 Python模拟和启示:认识激活
函数243
9.2.5 感知机的权重训练246
9.3 多层感知机网络251
9.3.1 多层感知机网络的结构251
9.3.2 多层感知机网络中的隐藏
节点253
9.3.3 Python模拟和启示:认识隐藏
节点255
9.4 B-P反向传播算法258
9.4.1 反向传播算法的基本思想258
9.4.2 局部梯度和权重更新258
*9.5 多层网络的其他问题260
9.6 人工神经网络的Python应用
实践261
9.6.1 手写体邮政编码的识别261
9.6.2 PM2.5浓度的回归预测264
【本章总结】265
【本章相关函数列表】265
【本章习题】266
第10章 特征选择:过滤、包裹和嵌入
策略267
10.1 过滤式策略下的特征选择268
10.1.1 低方差过滤法268
10.1.2 高相关过滤法中的方差分析270
10.1.3 高相关过滤法中的卡方检验273
10.1.4 Python应用实践:过滤法下手写体
邮政编码数字的特征选择275
*10.1.5 其他高相关过滤法278
10.2 包裹式策略下的特征选择280
10.2.1 包裹式策略的基本思路280
10.2.2 递归式特征剔除法281
10.2.3 基于交叉验证的递归式特征
剔除法281
10.2.4 Python应用实践:包裹式策略下
手写体邮政编码数字的特征选择282
10.3 嵌入式策略下的特征选择284
10.3.1 岭回归和Lasso回归284
10.3.2 弹性网回归287
10.3.3 Python应用实践:嵌入式策略下
手写体邮政编码数据的特征选择289
【本章总结】295
【本章相关函数列表】295
【本章习题】295
第11章 特征提取:空间变换策略296
11.1 主成分分析297
11.1.1 主成分分析的基本出发点297
11.1.2 主成分分析的基本原理299
11.1.3 确定主成分301
11.1.4 Python模拟和启示:认识主成分302
11.2 矩阵的奇异值分解304
11.2.1 奇异值分解的基本思路304
11.2.2 奇异值分解的Python应用实践:
脸部数据特征提取305
*11.3 核主成分分析307
11.3.1 核主成分分析的出发点307
11.3.2 核主成分分析的基本原理309
11.3.3 Python模拟和启示:认识核主
成分311
11.4 因子分析314
11.4.1 因子分析的基本出发点314
11.4.2 因子分析的基本原理315
11.4.3 Python模拟和启示:认识因子
分析的计算过程318
11.4.4 因子分析的其他问题322
11.4.5 因子分析的Python应用实践:
空气质量综合评测324
【本章总结】326
【本章相关函数列表】326
【本章习题】327
第12章 揭示数据内在结构:聚类
分析328
12.1 聚类分析概述328
12.1.1 聚类分析的目的328
12.1.2 聚类算法概述330
12.1.3 聚类解的评价331
12.1.4 聚类解的可视化334
12.2 基于质心的聚类模型:K-均值
聚类335
12.2.1 K-均值聚类基本过程335
12.2.2 基于K-均值聚类的类别预测337
12.2.3 Python模拟和启示:认识K-均值
聚类中的K337
12.3 基于连通性的聚类模型:系统
聚类341
12.3.1 系统聚类的基本过程341
12.3.2 系统聚类中距离的连通性测度341
12.3.3 Python模拟和启示:认识系统
聚类中的聚类数目K342
*12.4 基于高斯分布的聚类模型:
EM聚类347
12.4.1 出发点:有限混合分布347
12.4.2 EM聚类算法349
12.4.3 Python模拟和启示:认识EM
聚类351
12.5 聚类分析的Python应用实践:
环境污染的区域特征分析355
【本章总结】358
【本章相关函数列表】358
【本章习题】359
第13章 揭示数据内在结构:特色
聚类360
13.1 基于密度的聚类:DBSCAN
聚类360
13.1.1 DBSCAN聚类中的相关概念360
13.1.2 DBSCAN聚类过程362
13.1.3 Python模拟和启示:认识
DBSCAN的异形聚类特点362
*13.2 Mean-Shift聚类365
13.2.1 什么是核密度估计366
13.2.2 核密度估计在Mean-Shift聚类中的
意义367
13.2.3 Mean-Shift聚类过程369
13.2.4 Python模拟与启示:认识
Mean-Shift聚类中的核宽370
13.3 BIRCH聚类372
13.3.1 BIRCH聚类的特点372
13.3.2 BIRCH算法中的聚类特征树372
13.3.3 BIRCH聚类的基本思路375
13.3.4 Python模拟和启示:认识BIRCH
聚类的特点377
13.4 特色聚类的Python应用实践:
商品批发商的市场细分380
13.4.1 案例数据说明381
13.4.2 Python实现381
【本章总结】384
【本章相关函数列表】384
【本章习题】384
文摘▼
本书引领读者进入Python机器学习领域。机器学习是一套先进、深刻且内容丰富的算法集合,是数据科学领域主流的一类分析方法;Python是一款简明、高效且功能强大的开源工具,是数据科学领域最常用的计算机编程语言之一,它们相得益彰,构成了当今大数据技术、人工智能等前沿领域的必备知识技能,是数据科学人才培养的必修课。
本书采用理论与实践相结合的方式,对Python机器学习进行了系统介绍,理论上突出可读性并兼具知识深度和广度,实践上强调可操作性并兼具应用广泛性。对机器学习的原理部分进行了深入透彻的讲解,对机器学习的算法部分给出了Python实现,且在第3~13章均给出了可操作实现的应用案例。
本书可作为数据科学应用研究者以及对Python机器学习有兴趣的数据分析从业者的参考书,也非常适合作为高校数据科学与大数据技术专业、人工智能专业、大数据管理与应用或相近专业的“机器学习”“数据挖掘与机器学习”“机器学习与智能计算”“数据分析与建模”等相关课程的教材。