 正版
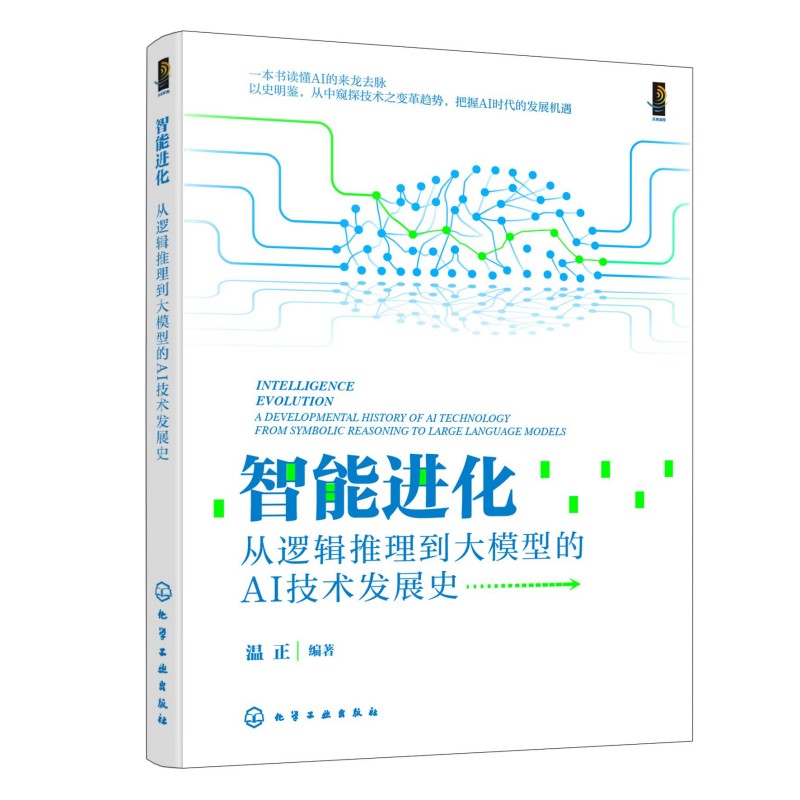
智能进化:从逻辑推理到大模型的AI技术发展史
- 书名
- 智能进化:从逻辑推理到大模型的AI技术发展史
- 作者
- 温正 编著
- 出版社
- 化学工业出版社
- 出版时间
- 2026-09-01
- ISBN
- 9787122509444
- 货号
- 1204493805
- 品相
- 全新
- 分类
- 涉及近代·哲学思想
- 书名
- 智能进化:从逻辑推理到大模型的AI技术发展史
- 作者
- 温正 编著
- 出版社
- 化学工业出版社
- 出版时间
- 2026-09-01
- ISBN
- 9787122509444
- 货号
- 1204493805
- 品相
- 全新
- 分类
- 涉及近代·哲学思想
作者简介▼
无
目录▼
第1篇 人工智能的起源与早期发展
第1章 人工智能的诞生:从逻辑推理到初代神经网络 002
1.1 图灵测试与AI概念的提出 002
1.1.1 图灵机的设计与计算理论的基石 002
1.1.2 图灵测试的哲学与技术意义 004
1.2 早期专家系统的应用:Dendral与MYCIN 006
1.2.1 Dendral的知识工程与化学分析应用 006
1.2.2 MYCIN在医疗诊断中的逻辑推理 007
1.3 感知机模型的起源与局限性 008
1.3.1 感知机的原理与线性分类问题 009
1.3.2 XOR问题与感知机研究的暂停 011
1.4 神经网络的首次爆发:Hopfield网络与BP算法 012
1.4.1 Hopfield网络的动态系统模型 013
1.4.2 BP算法的提出与多层网络的训练 015
1.5 冷战时期的AI应用与研究瓶颈 017
1.5.1 军事领域的AI探索:语言翻译与控制系统 017
1.5.2 经费削减与“AI寒冬”的到来 018
第2章 机器学习的兴起:从统计到算法 022
2.1 机器学习基础:线性回归与决策树的应用 022
2.1.1 线性回归的基本原理与应用场景 022
2.1.2 决策树的划分标准与信息增益 024
2.2 支持向量机与核方法的突破 028
2.2.1 SVM的数学几何直观与最大间隔原理 028
2.2.2 核方法的引入与非线性问题的解决 030
2.3 贝叶斯理论与概率图模型的引入 032
2.3.1 贝叶斯定理基本原理与实际应用 033
2.3.2 马尔可夫链与隐马尔可夫模型 034
2.4 集成学习方法:Bagging、Boosting与Random Forest 037
2.4.1 Bagging的并行架构与随机森林实现 037
2.4.2 Boosting的逐步优化与Adaboost算法 039
2.5 数据驱动的学习:机器学习的应用场景拓展 041
2.5.1 从数据到模型:语音识别的崛起 041
2.5.2 图像分类任务中的机器学习应用 043
第3章 深度学习的萌芽:早期多层网络的探索 049
3.1 神经网络的复兴:从BP算法到多层感知机 049
3.1.1 BP算法的导数链规则与误差反向传播 050
3.1.2 多层感知机的架构与非线性激活函数 052
3.2 卷积神经网络(CNN)的首次应用:LeNet与图像识别 055
3.2.1 卷积操作与局部感受野 056
3.2.2 LeNet的架构与手写数字识别应用 057
3.3 递归神经网络(RNN)与时间序列建模 060
3.3.1 RNN的循环结构与梯度爆炸问题 060
3.3.2 时间序列预测的应用实例 062
3.4 自编码器与生成模型的早期尝试 063
3.4.1 自编码器的对称结构与数据压缩 063
3.4.2 生成对抗网络的雏形:能量模型探索 067
3.5 深度学习困境:梯度消失与计算资源瓶颈 068
3.5.1 梯度消失的数学分析与激活函数改进 068
3.5.2 硬件与数据限制对模型扩展的影响 069
第2篇 深度学习的崛起与大模型的发展
第4章 深度学习的崛起:从AlexNet到现代架构 074
4.1 AlexNet的革命性突破:ImageNet挑战赛的胜利 074
4.1.1 ImageNet数据集的构建与关键意义 074
4.1.2 AlexNet的双GPU架构与ReLU激活函数 077
4.2 Dropout、Batch Normalization等优化策略的提出 081
4.2.1 Dropout的随机失活机制与正则化效果 082
4.2.2 Batch Normalization的归一化过程与训练加速 084
4.3 ResNet与Inception:深度学习网络结构的演进 085
4.3.1 ResNet的残差连接与深层网络的优化 086
4.3.2 Inception模块的并行卷积与参数优化 088
4.4 LSTM与GRU:序列数据建模的强化 091
4.4.1 LSTM的门控机制与长时依赖问题的解决 091
4.4.2 GRU的简化架构与性能对比 095
4.5 深度学习在计算机视觉与语音识别中的应用爆发 097
4.5.1 图像分类、目标检测与分割的全面发展 097
4.5.2 语音识别系统的深度学习解决方案 102
第5章 大数据时代:AI与数据的共生关系 106
5.1 数据的规模与质量对AI的影响 106
5.1.1 数据规模对模型性能的提升作用 106
5.1.2 数据清洗与特征工程对模型优化的关键性 108
5.2 数据清洗与标注:高质量数据集的构建 110
5.2.1 噪声数据的清洗 110
5.2.2 数据标注的自动化与众包 112
5.3 开源数据集:CIFAR-100、IMDb与COCO 114
5.3.1 CIFAR-100图像分类数据集 114
5.3.2 COCO数据集的多任务目标与使用场景 116
5.3.3 IMDb影评情感数据集 121
5.4 数据驱动AI的应用案例:广告、推荐与搜索引擎 123
5.4.1 推荐系统中的用户画像与特征提取 123
5.4.2 搜索引擎中的文本索引与排序优化 128
5.5 数据隐私与伦理问题:大数据时代的挑战 130
5.5.1 数据隐私保护的技术方法与法律框架 130
5.5.2 数据歧视与伦理问题的社会影响 131
第6章 自然语言处理的跃迁:从统计方法到Transformer 135
6.1 统计语言模型与词嵌入方法:从n-gram到Word2Vec 135
6.1.1 n-gram语言模型的原理与应用 135
6.1.2 Word2Vec的连续词袋模型与Skip-gram方法 137
6.2 Attention机制的提出与Seq2Seq架构的演化 138
6.2.1 Attention机制的原理与直观理解 139
6.2.2 Seq2Seq架构及其翻译任务中的应用 146
6.3 Transformer的诞生:Attention Is All You Need 149
6.3.1 Transformer架构的编码器与解码器模块 150
6.3.2 多头注意力与位置编码 154
6.4 BERT与GPT的单、双向语言建模 158
6.4.1 BERT的掩码语言模型与预训练过程 159
6.4.2 GPT的自回归建模与生成任务应用 161
6.5 NLP应用的广泛落地:翻译、问答与生成式AI 165
6.5.1 神经网络机器翻译的演进与产业应用 165
6.5.2 生成式AI在内容创作与对话系统中的应用 166
第7章 大模型的诞生:从预训练到微调 173
7.1 预训练模型的理论基础与优势 173
7.1.1 预训练-微调范式的提出与应用扩展 173
7.1.2 模型迁移学习的理论与实例 176
7.2 GPT系列与生成式AI模型的发展 178
7.2.1 GPT系列模型的规模增长与能力提升 178
7.2.2 大语言模型在文本生成任务中的具体实现 180
7.3 BERT、T5与多任务学习的实现 183
7.3.1 T5模型的文本转化框架与多任务适配 183
7.3.2 多任务学习对预训练模型性能的提升 185
7.4 微调与迁移学习:让模型适应特定任务 187
7.4.1 微调方法的分类:冻结层与增量训练 187
7.4.2 迁移学习在医学文本与法律分析中的应用 188
7.5 模型规模与性能的权衡:参数量的意义 190
7.5.1 参数规模对模型推理能力的影响 190
7.5.2 模型压缩与性能优化 192
第3篇 AI的技术融合与未来展望
第8章 AI硬件的突破:计算力与能效优化
8.1 GPU的崛起与并行计算在AI中的应用 196
8.1.1 GPU的架构特点与矩阵运算优化 196
8.1.2 CUDA编程模型在AI计算中的应用 198
8.2 TPU与ASIC:专用AI硬件的出现 200
8.2.1 TPU的加速逻辑与Google AI的部署 200
8.2.2 ASIC硬件的垂直优化与低功耗优势 201
8.3 云计算与分布式训练技术的发展 202
8.3.1 云端AI计算简介 203
8.3.2 分布式训练中的数据并行与模型并行 205
8.4 模型压缩与量化:剪枝、蒸馏与低精度计算 207
8.4.1 模型剪枝与知识蒸馏理论简介 207
8.4.2 低精度计算对推理性能的优化效果 210
8.5 算力与AI发展的相辅相成 213
8.5.1 算力规模对AI研究进展的推动作用 213
8.5.2 算力、算法与数据的动态平衡 215
第9章 跨模态与多模态的融合:视觉、语言与感知 218
9.1 多模态学习的理论基础:信息的联合表示 218
9.1.1 跨模态学习:嵌入与对齐 218
9.1.2 模态间的共享表示 222
9.2 图像与文本结合的应用:CLIP与DALL·E 224
9.2.1 CLIP的对比学习架构与跨模态任务 224
9.2.2 文生图模型:DALL·E 229
9.3 视觉-语言任务:VQA与跨模态检索 231
9.3.1 VQA任务:视觉与语言融合技术 231
9.3.2 跨模态检索模型架构 234
9.4 多模态感知的应用:自动驾驶与智能家居 236
9.4.1 自动驾驶中的多传感器融合技术 236
9.4.2 智能家居场景中的多模态AI应用 245
9.5 跨模态的未来挑战与研究方向 248
9.5.1 模态不平衡问题与数据稀缺性解决方案 248
9.5.2 跨模态研究的伦理与隐私问题 250
第10章 人工智能的未来:从技术突破到社会影响 253
10.1 强人工智能的技术路径与哲学争议 253
10.1.1 从窄人工智能到通用人工智能 253
10.1.2 强人工智能的伦理困境与哲学讨论 258
10.2 人工智能伦理:公平性与透明性 260
10.2.1 算法偏见检测与矫正技术 260
10.2.2 透明性与可解释性 262
10.3 AI在工业、医疗与教育中的前瞻应用 265
10.3.1 工业领域中的智能自动化 265
10.3.2 AI辅助医疗诊断支持 266
10.3.3 AI辅助教育事业 272
10.4 人机协作的未来:增强智能的潜力 273
10.4.1 人工智能与人类认知的互补关系 273
10.4.2 增强智能在工作场景中的应用 274
10.5 可持续发展与人工智能的长期影响 276
10.5.1 AI可持续发展:能源消耗与环境影响 276
10.5.2 可持续AI的研究趋势 277
附录 人工智能发展时间线 281
文摘▼
本书循序渐进地揭示了人工智能的技术演进与实际应用。首先从人工智能的早期理论入手,介绍了感知机、神经网络及深度学习的关键节点,并结合统计语言模型和自然语言处理中的实际案例,解析了技术如何从理论走向实践。随后聚焦于大模型时代的突破,深入探讨Transformer架构的出现及其后续模型(如BERT、GPT)的应用,同时延伸至微调与迁移学习的核心技术和多任务学习的实践价值。最后结合硬件进步和多模态学习的发展,探讨了人工智能如何在社会伦理、透明性与人机协作中与人类社会共存。
本书能够帮助读者全面了解人工智能从起源到未来的发展脉络,掌握核心技术与前沿动态。通过系统化的结构和清晰的叙述,为人工智能研究者、从业者和爱好者搭建了学习路径,既可以作为入门的理论指引,也能够启发读者思考人工智能技术的社会价值和未来潜力。