 正版
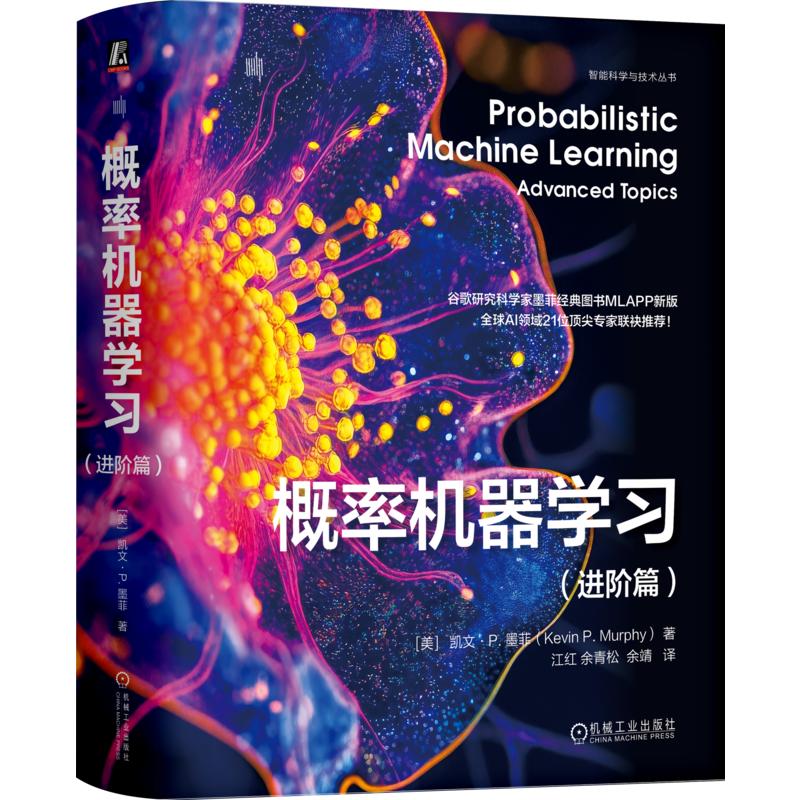
概率机器学习(进阶篇)(精装版)
- 书名
- 概率机器学习(进阶篇)(精装版)
- 作者
- [美]凯文·P.墨菲(Kevin P. Murphy) 著 江红 余青松 余靖 译
- 出版社
- 机械工业出版社
- 出版时间
- 2026-08-01
- ISBN
- 9787111812081
- 货号
- 1204479892
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- 概率机器学习(进阶篇)(精装版)
- 作者
- [美]凯文·P.墨菲(Kevin P. Murphy) 著 江红 余青松 余靖 译
- 出版社
- 机械工业出版社
- 出版时间
- 2026-08-01
- ISBN
- 9787111812081
- 货号
- 1204479892
- 品相
- 全新
- 分类
- 当代·工业
编辑推荐▼
本书源自作者2012年的著作《机器学习:概率视角》,它不是一个简单的更新版本,而是一本全新的著作,反映了自2012年以来机器学习领域的巨大发展,尤其是深度学习方面的进展。全书通过概率建模和贝叶斯决策理论的统一视角,详细且与时俱进地介绍了机器学习(包括深度学习)的理论和方法。由于篇幅限制,新版分为上下两卷:《概率机器学习(基础篇)》和《概率机器学习(进阶篇)》。本书作为下卷进阶篇,进一步拓展了机器学习的研究范畴,聚焦更具挑战性的问题,力求对机器学习各主题展开更为深入的探讨。
进阶篇主要分为六个部分:第一部分主要讨论机器学习所涉及的数学知识,包括概率论、统计学、图模型、信息论以及优化;第二部分主要讨论机器学习的推理算法,包括高斯滤波与平滑、消息传递算法、变分推理、蒙特卡罗方法、马尔可夫链蒙特卡罗方法以及序列蒙特卡罗方法;第三部分主要讨论机器学习的预测算法,包括广义线性模型、深度神经网络、贝叶斯神经网络、高斯过程以及非独立同分布的假设;第四部分主要讨论机器学习的生成算法,包括变分自动编码器、自回归模型、归一化流、基于能量的模型、扩散模型以及生成式对抗性网络;第五部分主要讨论机器学习的发现方法,包括潜在因子模型、状态空间模型、图学习、非参数化贝叶斯模型、表征学习以及可解释性;第六部分主要讨论机器学习的行为算法,包括不确定性决策、强化学习以及因果关系。
作者简介▼
凯文·P. 墨菲(Kevin P. Murphy)剑桥大学文学学士、宾夕法尼亚大学工程硕士、加州大学伯克利分校博士、麻省理工学院博士后。2004年,他成为加拿大温哥华不列颠哥伦比亚大学的计算机科学和统计学教授。2011年,他前往谷歌进行学术休假。2012年,他成为谷歌的全职研究科学家。他在机器学习和图模型相关的会议和期刊上发表了50多篇论文,并撰写了3本书。
目录▼
目 录
对本书的赞誉
译者序
前言
第1章 导论 ┊1
第一部分 理论基础
第2章 概率论 ┊4
2.1 概述 ┊4
2.1.1 概率空间 ┊4
2.1.2 离散随机变量 ┊4
2.1.3 连续随机变量 ┊5
2.1.4 概率公理 ┊6
2.1.5 条件概率 ┊7
2.1.6 贝叶斯规则 ┊7
2.2 一些常见的概率分布 ┊8
2.2.1 离散分布 ┊8
2.2.2 实数上的连续分布 ┊10
2.2.3 正实数上的连续分布 ┊13
2.2.4 在\[0,1\]上的连续分布 ┊16
2.2.5 多元连续分布 ┊16
2.3 高斯联合分布 ┊21
2.3.1 多元高斯分布 ┊21
2.3.2 线性高斯系统 ┊27
2.3.3 线性高斯系统的通用微积分知识 ┊30
2.4 指数族 ┊33
2.4.1 定义 ┊33
2.4.2 示例 ┊34
2.4.3 对数配分函数是累积量生成函数 ┊38
2.4.4 规范化(自然)参数与均值(矩)参数 ┊39
2.4.5 指数族的最大似然估计 ┊40
2.4.6 指数分散族 ┊41
2.4.7 指数族的最大熵推导 ┊41
2.5 随机变量的变换 ┊42
2.5.1 可逆变换(双射) ┊42
2.5.2 蒙特卡罗近似 ┊43
2.5.3 概率积分变换 ┊43
2.6 马尔可夫链 ┊45
2.6.1 参数化 ┊45
2.6.2 应用:语言建模 ┊47
2.6.3 参数估计 ┊47
2.6.4 马尔可夫链的平稳分布 ┊49
2.7 概率分布之间的散度度量 ┊53
2.7.1 f散度 ┊54
2.7.2 积分概率度量 ┊55
2.7.3 最大均值差异 ┊56
2.7.4 总变差距离 ┊59
2.7.5 使用二元分类器的密度比估计 ┊59
第3章 统计学 ┊61
3.1 概述 ┊61
3.2 贝叶斯统计 ┊61
3.2.1 投掷硬币 ┊62
3.2.2 对更复杂的数据建模 ┊68
3.2.3 选择先验 ┊69
3.2.4 计算问题 ┊69
3.2.5 可交换性和de Finetti定理 ┊70
3.3 频率学派统计 ┊70
3.3.1 采样分布 ┊71
3.3.2 采样分布的自举法近似 ┊72
3.3.3 最大似然估计采样分布的渐近正态性 ┊72
3.3.4 Fisher信息矩阵 ┊73
3.3.5 频率学派统计的反直觉性质 ┊77
3.3.6 为什么有人不坚持贝叶斯学派统计理论 ┊80
3.4 共轭先验 ┊82
3.4.1 二项式模型 ┊82
3.4.2 多项式模型 ┊82
3.4.3 单变量高斯分布模型 ┊83
3.4.4 多元高斯分布模型 ┊88
3.4.5 指数族模型 ┊93
3.4.6 超越共轭先验 ┊95
3.5 无信息性的先验 ┊99
3.5.1 最大熵先验 ┊99
3.5.2 Jeffreys先验 ┊100
3.5.3 不变性先验 ┊102
3.5.4 参照先验 ┊103
3.6 层次先验 ┊104
3.6.1 层次二项式模型 ┊105
3.6.2 层次高斯分布模型 ┊106
3.6.3 层次条件模型 ┊109
3.7 经验贝叶斯 ┊109
3.7.1 层次二项式模型的经验贝叶斯 ┊110
3.7.2 层次高斯分布模型的经验贝叶斯 ┊111
3.7.3 马尔可夫模型的经验贝叶斯(n元组平滑) ┊112
3.7.4 非共轭模型的经验贝叶斯 ┊114
3.8 模型选择 ┊114
3.8.1 贝叶斯模型选择 ┊114
3.8.2 贝叶斯模型平均 ┊115
3.8.3 估计边缘似然 ┊116
3.8.4 交叉验证与边缘似然之间的联系 ┊117
3.8.5 条件边缘似然 ┊118
3.8.6 贝叶斯留一估计 ┊119
3.8.7 信息准则 ┊120
3.9 模型检查 ┊122
3.9.1 后验预测性检查 ┊123
3.9.2 贝叶斯p值 ┊125
3.10 假设检验 ┊126
3.10.1 频率学派统计的方法 ┊126
3.10.2 贝叶斯方法 ┊127
3.10.3 常见的统计检验对应于线性模型中的推理 ┊131
3.11 缺失数据 ┊136
第4章 图模型 ┊138
4.1 概述 ┊138
4.2 有向图模型(贝叶斯网) ┊138
4.2.1 表示联合分布 ┊139
4.2.2 示例 ┊139
4.2.3 高斯贝叶斯网 ┊143
4.2.4 条件独立性 ┊144
4.2.5 生成(采样) ┊149
4.2.6 推理 ┊149
4.2.7 学习 ┊151
4.2.8 板块表示法 ┊155
4.3 无向图模型(马尔可夫随机场) ┊157
4.3.1 表示联合分布 ┊158
4.3.2 完全可见的马尔可夫随机场 ┊159
4.3.3 具有潜在变量的马尔可夫随机场 ┊165
4.3.4 最大熵模型 ┊167
4.3.5 高斯马尔可夫随机场 ┊169
4.3.6 条件独立性 ┊171
4.3.7 生成(采样) ┊173
4.3.8 推理 ┊173
4.3.9 学习 ┊174
4.4 条件随机场 ┊178
4.4.1 一维条件随机场 ┊178
4.4.2 二维条件随机场 ┊181
4.4.3 参数估计 ┊183
4.4.4 结构化预测的其他方法 ┊184
4.5 比较有向和无向概率图模型 ┊185
4.5.1 条件独立性质 ┊185
4.5.2 有向模型和无向模型之间的转换 ┊186
4.5.3 比较条件有向概率图模型和无向概率图模型与标签偏差问题 ┊188
4.5.4 有向图和无向图的组合 ┊188
4.5.5 比较有向高斯概率图模型和无向高斯概率图模型 ┊190
4.6 概率图模型扩展 ┊192
4.6.1 因子图 ┊192
4.6.2 概率电路 ┊194
4.6.3 有向关系概率图模型 ┊195
4.6.4 无向关系概率图模型 ┊197
4.6.5 开放宇宙概率模型 ┊200
4.6.6 作为概率模型的程序 ┊201
4.7 结构因果模型 ┊201
4.7.1 示例:教育对财富的因果影响 ┊202
4.7.2 结构方程模型 ┊203
4.7.3 do运算符和增强的有向无环图 ┊203
4.7.4 反事实推理 ┊205
第5章 信息论 ┊207
5.1 KL散度 ┊208
5.1.1 需求条件 ┊208
5.1.2 KL散度唯一满足需求条件 ┊210
5.1.3 关于KL散度的思考 ┊212
5.1.4 最小化KL散度 ┊214
5.1.5 KL散度的性质 ┊216
5.1.6 KL散度和最大似然估计 ┊218
5.1.7 KL散度和贝叶斯推理 ┊219
5.1.8 KL散度和指数族 ┊220
5.1.9 使用Fisher信息矩阵近似KL散度 ┊220
5.1.10 Bregman散度 ┊221
5.2 熵 ┊222
5.2.1 定义 ┊222
5.2.2 连续随机变量的微分熵 ┊223
5.2.3 典型集 ┊224
5.2.4 交叉熵与困惑度 ┊224
5.3 互信息 ┊225
5.3.1 定义 ┊225
5.3.2 解释 ┊226
5.3.3 数据处理不等式 ┊226
5.3.4 充分统计量 ┊227
5.3.5 多元互信息 ┊228
5.3.6 互信息的变分上下界 ┊231
5.3.7 相关性网络 ┊233
5.4 数据压缩(源编码) ┊235
5.4.1 无损压缩 ┊235
5.4.2 有损压缩和“数据率失真度”的权衡 ┊235
5.4.3 比特反向编码 ┊238
5.5 纠错码(信道编码) ┊239
5.6 信息瓶颈 ┊240
5.6.1 基本信息瓶颈 ┊240
5.6.2 变分信息瓶颈 ┊241
5.6.3 条件熵瓶颈 ┊243
第6章 优化 ┊245
6.1 概述 ┊245
6.2 自动微分 ┊245
6.2.1 函数形式的微分 ┊246
6.2.2 微分链、电路和程序 ┊249
6.3 随机优化 ┊255
6.3.1 随机梯度下降 ┊255
6.3.2 用于优化“有限和”目标的随机梯度下降 ┊256
6.3.3 用于优化分布参数的随机梯度下降 ┊257
6.3.4 得分函数估计器 ┊258
6.3.5 重新参数化的技巧 ┊259
6.3.6 Gumbel softmax技巧 ┊261
6.3.7 随机计算图 ┊262
6.3.8 直通式估计器 ┊262
6.4 自然梯度下降 ┊263
6.4.1 定义自然梯度 ┊264
6.4.2 自然梯度下降的解释 ┊264
6.4.3 自然梯度下降的优点 ┊265
6.4.4 近似自然梯度 ┊267
6.4.5 指数族的自然梯度 ┊268
6.5 边界优化算法 ┊270
6.5.1 通用算法 ┊270
6.5.2 示例:逻辑回归 ┊271
6.5.3 期望最大化算法 ┊272
6.5.4 示例:缺失数据多元正态分布的期望最大化算法 ┊275
6.5.5 示例:使用学生似然的稳健线性回归 ┊276
6.5.6 期望最大化算法的扩展 ┊278
6.6 贝叶斯优化方法 ┊281
6.6.1 基于序列模型的优化 ┊281
6.6.2 代理函数 ┊283
6.6.3 采集函数 ┊284
6.6.4 其他问题 ┊287
6.7 无导数优化 ┊288
6.7.1 本地搜索 ┊288
6.7.2 模拟退火 ┊291
6.7.3 进化算法 ┊291
6.7.4 分布估计算法 ┊294
6.7.5 交叉熵方法 ┊296
6.7.6 进化策略 ┊296
6.8 最优传输 ┊297
6.8.1 预热:最优匹配两个点族 ┊298
6.8.2 从最优匹配到Kantorovich和Monge公式 ┊299
6.8.3 求解最优传输 ┊301
6.9 子模优化 ┊305
6.9.1 直觉、示例和背景 ┊306
6.9.2 子模的基本定义 ┊309
6.9.3 子模函数示例 ┊310
6.9.4 子模优化方法 ┊313
6.9.5 子模在机器学习和人工智能中的应用 ┊317
6.9.6 草图、核心集、蒸馏、数据子集和特征选择 ┊317
6.9.7 组合信息函数 ┊321
6.9.8 聚类、数据划分和并行机器学习 ┊322
6.9.9 主动学习和半监督学习 ┊323
6.9.10 概率建模 ┊324
6.9.11 结构化范数和损失函数 ┊325
6.9.12 结论 ┊326
第二部分 推 理
第7章 推理算法:综述 ┊328
7.1 概述 ┊328
7.2 常见推理模式 ┊329
7.2.1 全局潜在变量 ┊329
7.2.2 局部潜在变量 ┊329
7.2.3 局部和全局潜在变量 ┊330
7.3 精确推理算法 ┊331
7.4 近似推理算法 ┊331
7.4.1 最大后验估计近似及其问题 ┊332
7.4.2 网格近似 ┊333
7.4.3 拉普拉斯(二次型)近似 ┊334
7.4.4 变分推理 ┊335
7.4.5 马尔可夫链蒙特卡罗 ┊337
7.4.6 序列蒙特卡罗 ┊338
7.4.7 挑战后验概率 ┊338
7.5 评估近似推理算法 ┊339
第8章 高斯滤波与平滑 ┊340
8.1 概述 ┊340
8.1.1 推理目标 ┊340
8.1.2 贝叶斯滤波方程 ┊342
8.1.3 贝叶斯平滑方程 ┊343
8.1.4 高斯假设 ┊344
8.2 线性高斯状态空间模型的推理 ┊344
8.2.1 示例 ┊345
8.2.2 卡尔曼滤波器 ┊346
8.2.3 卡尔曼平滑器 ┊350
8.2.4 信息形式的滤波和平滑 ┊353
8.3 基于局部线性化的推理 ┊355
8.3.1 泰勒级数展开 ┊356
8.3.2 扩展卡尔曼滤波器 ┊357
8.3.3 扩展卡尔曼平滑器 ┊359
8.4 基于无迹变换的推理 ┊360
8.4.1 无迹变换 ┊360
8.4.2 无迹卡尔曼滤波器 ┊361
8.4.3 无迹卡尔曼平滑器 ┊362
8.5 卡尔曼滤波器的其他变体 ┊363
8.5.1 广义高斯滤波 ┊363
8.5.2 条件矩高斯滤波 ┊366
8.5.3 迭代滤波器和平滑器 ┊367
8.5.4 集成卡尔曼滤波器 ┊368
8.5.5 鲁棒卡尔曼滤波器 ┊369
8.5.6 双扩展卡尔曼滤波器 ┊370
8.6 假设密度滤波 ┊370
8.6.1 与高斯滤波的连接 ┊371
8.6.2 切换线性动力系统的假设密度滤波(“高斯和”滤波器) ┊372
8.6.3 在线逻辑回归的假设密度滤波 ┊374
8.6.4 在线深度神经网络的假设密度滤波 ┊377
8.7 状态空间模型的其他推理方法 ┊377
8.7.1 基于网格的近似 ┊377
8.7.2 期望传播 ┊378
8.7.3 变分推理 ┊379
8.7.4 马尔可夫链蒙特卡罗 ┊379
8.7.5 粒子滤波 ┊379
第9章 消息传递算法 ┊380
9.1 概述 ┊380
9.2 链上的信念传播 ┊381
9.2.1 隐马尔可夫模型 ┊381
9.2.2 前向算法 ┊382
9.2.3 “前向后向”算法 ┊383
9.2.4 前向滤波后向平滑 ┊386
9.2.5 时间复杂度和空间复杂度 ┊387
9.2.6 Viterbi算法 ┊387
9.2.7 前向滤波后向采样 ┊390
9.3 树上的信念传播 ┊390
9.3.1 有向树与无向树 ┊391
9.3.2 和积算法 ┊392
9.3.3 最大乘积算法 ┊393
9.4 循环信念传播 ┊395
9.4.1 成对无向图的循环信念传播 ┊396
9.4.2 因子图的循环信念传播 ┊396
9.4.3 高斯信念传播 ┊397
9.4.4 收敛 ┊398
9.4.5 准确率 ┊401
9.4.6 广义信念传播 ┊401
9.4.7 凸信念传播 ┊402
9.4.8 应用:纠错码 ┊402
9.4.9 应用:近邻传播 ┊403
9.4.10 使用图神经网络模拟信念传播 ┊405
9.5 变量消除算法 ┊406
9.5.1 算法的推导 ┊406
9.5.2 变量消除的计算复杂度 ┊407
9.5.3 选择一个好的消除顺序 ┊409
9.5.4 精确推理的计算复杂度 ┊410
9.5.5 变量消除的缺点 ┊411
9.6 联结树算法 ┊412
9.7 作为优化的推理 ┊412
9.7.1 作为反向传播的推理 ┊412
9.7.2 扰动和最大后验估计 ┊413
第10章 变分推理 ┊416
10.1 概述 ┊416
10.1.1 变分目标 ┊416
10.1.2 变分后验的形式 ┊418
10.1.3 使用变分期望最大化的参数估计 ┊419
10.1.4 随机变分推理 ┊420
10.1.5 摊销变分推理 ┊421
10.1.6 半摊销推理 ┊421
10.2 基于梯度的变分推理 ┊422
10.2.1 重新参数化变分推理 ┊422
10.2.2 自动微分变分推理 ┊428
10.2.3 黑盒变分推理 ┊430
10.3 坐标上升变分推理 ┊431
10.3.1 坐标上升变分推理算法的推导 ┊431
10.3.2 示例:Ising模型的坐标上升变分推理 ┊433
10.3.3 变分贝叶斯 ┊434
10.3.4 示例:变分贝叶斯用于单变量高斯 ┊435
10.3.5 变分贝叶斯期望最大化 ┊438
10.3.6 示例:高斯混合模型的变分贝叶斯期望最大化 ┊439
10.3.7 变分消息传递 ┊444
10.3.8 autoconj ┊445
10.4 更准确的变分后验 ┊445
10.4.1 结构化均值场 ┊445
10.4.2 层次(辅助变量)后验 ┊446
10.4.3 归一化流后验 ┊446
10.4.4 隐式后验 ┊447
10.4.5 将变分推理与马尔可夫链蒙特卡罗推理相结合 ┊447
10.5 更严格的下界 ┊447
10.5.1 多样本证据下界 ┊447
10.5.2 热力学变分目标 ┊448
10.5.3 最小化证据上界 ┊449
10.6 唤醒睡眠算法 ┊449
10.6.1 “唤醒”阶段 ┊450
10.6.2 “睡眠”阶段 ┊451
10.6.3 “白日梦”阶段 ┊451
10.6.4 算法总结 ┊452
10.7 期望传播 ┊453
10.7.1 期望传播的算法 ┊453
10.7.2 示例 ┊455
10.7.3 作为广义假设密度滤波的期望传播 ┊455
10.7.4 优化问题 ┊455
10.7.5 幂期望传播和阿尔法散度 ┊456
10.7.6 随机期望传播 ┊456
第11章 蒙特卡罗方法 ┊458
11.1 概述 ┊458
11.2 蒙特卡罗积分 ┊458
11.2.1 示例:通过蒙特卡罗积分估计π ┊459
11.2.2 蒙特卡罗积分的准确度 ┊459
11.3 从简单分布生成随机样本 ┊460
11.3.1 使用反向累积分布函数进行采样 ┊461
11.3.2 高斯采样(BoxMuller法) ┊462
11.4 拒绝采样 ┊462
11.4.1 基本思想 ┊463
11.4.2 示例 ┊464
11.4.3 自适应拒绝采样 ┊464
11.4.4 高维空间中的拒绝采样 ┊465
11.5 重要性采样 ┊465
11.5.1 直接重要性采样 ┊466
11.5.2 自归一化重要性采样 ┊466
11.5.3 选择提议分布 ┊467
11.5.4 退火重要性采样 ┊468
11.6 控制蒙特卡罗方差 ┊469
11.6.1 常见随机数 ┊469
11.6.2 RaoBlackwellization ┊469
11.6.3 控制变量法 ┊470
11.6.4 对偶采样 ┊471
11.6.5 准蒙特卡罗 ┊472
第12章 马尔可夫链蒙特卡罗方法 ┊474
12.1 概述 ┊474
12.2 MetropolisHastings算法 ┊475
12.2.1 基本思想 ┊475
12.2.2 MetropolisHastings算法为什么有效 ┊476
12.2.3 提议分布 ┊477
12.2.4 初始化 ┊480
12.3 吉布斯采样 ┊480
12.3.1 基本思想 ┊480
12.3.2 吉布斯采样是MetropolisHastings的一种特殊情况 ┊481
12.3.3 示例:Ising模型的吉布斯采样 ┊481
12.3.4 示例:Potts模型的吉布斯采样 ┊483
12.3.5 示例:高斯混合模型的吉布斯采样 ┊483
12.3.6 吉布斯采样中的Metropolis算法 ┊485
12.3.7 分块吉布斯采样 ┊485
12.3.8 塌陷吉布斯采样 ┊486
12.4 辅助变量马尔可夫链蒙特卡罗方法 ┊488
12.4.1 切片采样 ┊488
12.4.2 SwendsenWang ┊490
12.5 哈密尔顿蒙特卡罗方法 ┊491
12.5.1 哈密尔顿力学 ┊492
12.5.2 积分哈密尔顿方程 ┊493
12.5.3 哈密尔顿蒙特卡罗算法 ┊494
12.5.4 微调哈密尔顿蒙特卡罗方法 ┊495
12.5.5 黎曼流形哈密尔顿蒙特卡罗方法 ┊496
12.5.6 朗之万蒙特卡罗方法 ┊496
12.5.7 随机梯度下降和朗之万采样之间的联系 ┊497
12.5.8 将哈密尔顿蒙特卡罗方法应用于受约束的参数 ┊498
12.5.9 加速哈密尔顿蒙特卡罗方法 ┊499
12.6 马尔可夫链蒙特卡罗收敛 ┊499
12.6.1 马尔可夫链的混合率 ┊500
12.6.2 实用收敛诊断 ┊501
12.6.3 有效样本容量 ┊504
12.6.4 提高收敛速度 ┊506
12.6.5 非中心参数化和Neal漏斗 ┊506
12.7 随机梯度马尔可夫链蒙特卡罗方法 ┊507
12.7.1 随机梯度朗之万动力学 ┊508
12.7.2 预处理 ┊508
12.7.3 降低梯度估计的方差 ┊509
12.7.4 SGHMC ┊510
12.7.5 欠阻尼朗之万动力学 ┊510
12.8 可逆跳跃(跨维)马尔可夫链蒙特卡罗 ┊511
12.8.1 基本思想 ┊512
12.8.2 示例 ┊512
12.8.3 讨论 ┊514
12.9 退火方法 ┊514
12.9.1 模拟退火 ┊514
12.9.2 并行回火 ┊516
第13章 序列蒙特卡罗方法 ┊518
13.1 概述 ┊518
13.1.1 问题陈述 ┊518
13.1.2 状态空间模型的粒子滤波 ┊519
13.1.3 用于静态参数估计的序列蒙特卡罗采样器 ┊520
13.2 粒子滤波 ┊520
13.2.1 重要性采样 ┊521
13.2.2 序列重要性采样 ┊521
13.2.3 带重新采样的序列重要性采样 ┊523
13.2.4 重新采样方法 ┊526
13.2.5 自适应重新采样 ┊528
13.3 提议分布 ┊529
13.3.1 局部最优提议分布 ┊529
13.3.2 基于扩展无迹卡尔曼滤波器的提议分布 ┊529
13.3.3 基于拉普拉斯近似的提议分布 ┊530
13.3.4 基于序列蒙特卡罗的提议分布(嵌套序列蒙特卡罗) ┊531
13.4 RaoBlackwellized粒子滤波 ┊532
13.4.1 卡尔曼滤波器的混合 ┊532
13.4.2 示例:跟踪机动物体 ┊534
13.4.3 示例:FastSLAM ┊535
13.5 粒子滤波器的扩展 ┊538
13.6 序列蒙特卡罗采样器 ┊538
13.6.1 序列蒙特卡罗采样器的成分 ┊539
13.6.2 似然回火(几何路径) ┊540
13.6.3 数据回火 ┊542
13.6.4 罕见事件和极值的采样 ┊543
13.6.5 序列蒙特卡罗近似贝叶斯计算和无似然推理 ┊544
13.6.6 SMC2 ┊544
13.6.7 变分滤波序列蒙特卡罗方法 ┊545
13.6.8 变分平滑序列蒙特卡罗方法 ┊545
第三部分 预 测
第14章 预测模型:概述 ┊548
14.1 概述 ┊548
14.1.1 预测模型的类型 ┊548
14.1.2 使用ERM、MLE和MAP的模型拟合 ┊549
14.1.3 使用贝叶斯、变分推理和广义贝叶斯的模型拟合 ┊550
14.2 评估预测模型 ┊551
14.2.1 适当的评分规则 ┊551
14.2.2 校准 ┊551
14.2.3 评估边缘概率以外的其他方法 ┊555
14.3 共形预测 ┊558
14.3.1 共形分类 ┊560
14.3.2 共形回归 ┊560
第15章 广义线性模型 ┊562
15.1 概述 ┊562
15.1.1 一些流行的广义线性模型 ┊562
15.1.2 具有非规范链接函数的广义线性模型 ┊565
15.1.3 最大似然估计 ┊566
15.1.4 贝叶斯推理 ┊567
15.2 线性回归 ┊567
15.2.1 普通最小二乘法 ┊567
15.2.2 共轭先验 ┊568
15.2.3 无信息性先验 ┊570
15.2.4 信息先验 ┊572
15.2.5 “尖峰和平板”先验 ┊574
15.2.6 拉普拉斯先验(贝叶斯套索) ┊575
15.2.7 “马蹄”先验 ┊576
15.2.8 自动相关性确定 ┊577
15.2.9 多元线性回归 ┊579
15.3 逻辑回归 ┊581
15.3.1 二元逻辑回归 ┊581
15.3.2 多项式逻辑回归 ┊582
15.3.3 处理类别不平衡和长尾问题 ┊582
15.3.4 参数先验分布 ┊583
15.3.5 后验的拉普拉斯近似 ┊584
15.3.6 近似后验预测分布 ┊586
15.3.7 马尔可夫链蒙特卡罗推理 ┊587
15.3.8 其他近似推理方法 ┊589
15.3.9 案例研究:伯克利分校的录取是否对女性有偏见 ┊589
15.4 probit回归 ┊591
15.4.1 潜在变量解释 ┊592
15.4.2 最大似然估计 ┊593
15.4.3 贝叶斯推理 ┊594
15.4.4 有序probit回归 ┊594
15.4.5 多项式probit模型 ┊595
15.5 多级(分层)广义线性模型 ┊595
15.5.1 广义线性混合模型 ┊596
15.5.2 示例:氡回归 ┊597
第16章 深度神经网络 ┊600
16.1 概述 ┊600
16.2 可微电路的构建块 ┊601
16.2.1 线性层 ┊601
16.2.2 非线性现象 ┊601
16.2.3 卷积层 ┊602
16.2.4 残差(跳过)连接 ┊603
16.2.5 归一化层 ┊604
16.2.6 dropout层 ┊604
16.2.7 注意力层 ┊605
16.2.8 循环层 ┊607
16.2.9 乘法层 ┊607
16.2.10 隐式层 ┊608
16.3 神经网络的典型例子 ┊609
16.3.1 多层感知器 ┊609
16.3.2 卷积神经网络 ┊610
16.3.3 自动编码器 ┊611
16.3.4 循环神经网络 ┊611
16.3.5 Transformer ┊612
16.3.6 图神经网络 ┊613
第17章 贝叶斯神经网络 ┊614
17.1 概述 ┊614
17.2 贝叶斯神经网络的先验 ┊615
17.2.1 高斯先验 ┊615
17.2.2 稀疏性提升先验 ┊617
17.2.3 学习先验 ┊617
17.2.4 函数空间中的先验 ┊617
17.2.5 架构先验 ┊618
17.3 贝叶斯神经网络的后验 ┊618
17.3.1 蒙特卡罗丢弃法 ┊618
17.3.2 拉普拉斯近似 ┊619
17.3.3 变分推理 ┊620
17.3.4 期望传播 ┊621
17.3.5 最后一层方法 ┊622
17.3.6 频谱归一化高斯过程 ┊622
17.3.7 马尔可夫链蒙特卡罗方法 ┊623
17.3.8 基于随机梯度下降轨迹的方法 ┊623
17.3.9 深度集成 ┊625
17.3.10 近似后验预测分布 ┊628
17.3.11 回火后验和冷却后验 ┊631
17.4 贝叶斯深度学习中的泛化 ┊632
17.4.1 尖锐与平坦的极小值 ┊632
17.4.2 模式连通性和损失景观 ┊633
17.4.3 模型的有效维度 ┊634
17.4.4 深度神经网络的假设空间 ┊635
17.4.5 PAC贝叶斯 ┊636
17.4.6 贝叶斯神经网络的分布外泛化 ┊637
17.4.7 贝叶斯神经网络的模型选择 ┊639
17.5 在线推理 ┊639
17.5.1 深度神经网络的序列拉普拉斯 ┊639
17.5.2 深度神经网络的扩展卡尔曼滤波 ┊640
17.5.3 深度神经网络的假设密度过滤 ┊642
17.5.4 深度神经网络的在线变分推理 ┊643
17.6 层次贝叶斯神经网络 ┊644
17.6.1 示例:多卫星分类 ┊645
第18章 高斯过程 ┊648
18.1 概述 ┊648
18.1.1 高斯过程的概念以及使用的原因 ┊648
18.2 Mercer核 ┊650
18.2.1 平稳核 ┊651
18.2.2 非平稳核 ┊655
18.2.3 非向量(结构化)输入的核 ┊656
18.2.4 从旧核中创建新核 ┊656
18.2.5 Mercer定理 ┊657
18.2.6 具有随机特征的近似核 ┊659
18.3 高斯似然的高斯过程 ┊660
18.3.1 使用无噪声观测的预测 ┊660
18.3.2 使用噪声观测的预测 ┊661
18.3.3 权重空间与函数空间 ┊662
18.3.4 半参数化高斯过程 ┊663
18.3.5 边缘似然 ┊663
18.3.6 计算和数值问题 ┊664
18.3.7 核岭回归 ┊664
18.4 具有非高斯似然的高斯过程 ┊667
18.4.1 二元分类 ┊668
18.4.2 多类别分类 ┊669
18.4.3 泊松回归的高斯过程(Cox过程) ┊670
18.4.4 其他似然 ┊671
18.5 将高斯过程推理扩展到大型数据集 ┊671
18.5.1 数据子集 ┊672
18.5.2 Nystrm近似 ┊672
18.5.3 诱导点方法 ┊673
18.5.4 稀疏变分法 ┊677
18.5.5 通过核矩阵乘法利用并行化和结构 ┊680
18.5.6 将高斯过程转换为状态空间模型 ┊683
18.6 学习核 ┊683
18.6.1 核参数的经验贝叶斯 ┊684
18.6.2 核参数的贝叶斯推断 ┊686
18.6.3 加性核的多核学习 ┊688
18.6.4 组成核的自动搜索 ┊689
18.6.5 谱混合核学习 ┊691
18.6.6 深度核学习 ┊692
18.7 高斯过程和深度神经网络 ┊694
18.7.1 源自无限宽深度神经网络的核 ┊694
18.7.2 神经正切核 ┊696
18.7.3 深度高斯过程 ┊697
18.8 时间序列预测的高斯过程 ┊698
18.8.1 示例:Mauna Loa ┊698
第19章 非独立同分布的假设 ┊700
19.1 概述 ┊700
19.2 分布偏移 ┊700
19.2.1 激励示例 ┊701
19.2.2 分布偏移的因果观 ┊702
19.2.3 分布偏移的4种主要类型 ┊703
19.2.4 选择偏差 ┊704
19.3 检测分布偏移 ┊705
19.3.1 使用双样本检验来检测偏移 ┊705
19.3.2 检测单个分布外输入 ┊706
19.3.3 选择性预测 ┊709
19.3.4 开放集识别和开放世界识别 ┊710
19.4 分布偏移的鲁棒性 ┊710
19.4.1 数据增强 ┊710
19.4.2 分布式鲁棒优化 ┊711
19.5 适应分布偏移 ┊711
19.5.1 使用迁移学习的监督适应 ┊711
19.5.2 协变量偏移的加权经验风险最小化 ┊713
19.5.3 协变量偏移的无监督领域自适应 ┊714
19.5.4 标签偏移的无监督技术 ┊715
19.5.5 测试时自适应 ┊716
19.6 从多种分布中学习 ┊717
19.6.1 多任务学习 ┊717
19.6.2 领域泛化 ┊718
19.6.3 不变风险最小化 ┊719
19.6.4 元学习 ┊720
19.7 持续学习 ┊722
19.7.1 领域漂移 ┊723
19.7.2 概念漂移 ┊723
19.7.3 任务增量学习 ┊724
19.7.4 灾难性遗忘 ┊726
19.7.5 在线学习 ┊727
19.8 对抗性样例 ┊728
19.8.1 白盒(基于梯度的)攻击 ┊729
19.8.2 黑盒(无梯度)攻击 ┊730
19.8.3 真实世界的对抗性攻击 ┊731
19.8.4 基于鲁棒优化的防御 ┊732
19.8.5 为什么模型具有对抗性样例 ┊733
第四部分 生 成
第20章 生成模型:概述 ┊736
20.1 概述 ┊736
20.2 生成模型的类型 ┊736
20.3 生成式建模的目标 ┊738
20.3.1 生成数据 ┊738
20.3.2 密度估计 ┊740
20.3.3 插值 ┊741
20.3.4 结构发现 ┊742
20.3.5 潜在空间插值 ┊742
20.3.6 潜在空间算术运算 ┊744
20.3.7 生成式设计 ┊744
20.3.8 基于模型的强化学习 ┊745
20.3.9 表征学习 ┊745
20.3.10 数据压缩 ┊745
20.4 评估生成模型 ┊745
20.4.1 基于似然的评估 ┊745
20.4.2 特征空间中的距离和离散度 ┊747
20.4.3 精度和召回率指标 ┊749
20.4.4 统计测试 ┊749
20.4.5 使用预训练分类器的挑战 ┊750
20.4.6 使用模型样本训练分类器 ┊750
20.4.7 评估过拟合 ┊750
20.4.8 人工评估 ┊751
第21章 变分自动编码器 ┊752
21.1 概述 ┊752
21.2 变分自动编码器的基础知识 ┊753
21.2.1 建模假设 ┊753
21.2.2 模型拟合 ┊753
21.2.3 变分自动编码器和自动编码器的比较 ┊754
21.2.4 变分自动编码器在增强空间中优化 ┊756
21.3 变分自动编码器泛化 ┊757
21.3.1 β变分自动编码器 ┊757
21.3.2 InfoVAE ┊759
21.3.3 多模态变分自动编码器 ┊761
21.3.4 半监督变分自动编码器 ┊763
21.3.5 带序列编码器/解码器的变分自动编码器 ┊764
21.4 避免后验塌陷 ┊767
21.4.1 KL退火 ┊767
21.4.2 限制速率下界 ┊768
21.4.3 免费比特 ┊768
21.4.4 添加跳跃连接 ┊768
21.4.5 改进的变分推理 ┊768
21.4.6 替代目标 ┊769
21.5 具有层次结构的变分自动编码器 ┊769
21.5.1 自底向上的推理和自顶向下的推理 ┊770
21.5.2 示例:超级深度变分自动编码器 ┊771
21.5.3 与自回归模型的联系 ┊772
21.5.4 变分剪枝 ┊773
21.5.5 关于优化的其他难点 ┊774
21.6 向量量化变分自动编码器 ┊774
21.6.1 带二元编码的自动编码器 ┊775
21.6.2 VQVAE模型 ┊775
21.6.3 学习先验知识 ┊777
21.6.4 层次扩展(VQVAE2) ┊777
21.6.5 离散变分自动编码器 ┊778
21.6.6 VQGAN ┊779
第22章 自回归模型 ┊780
22.1 概述 ┊780
22.2 神经自回归密度估计器 ┊781
22.3 因果卷积神经网络 ┊781
22.3.1 一维因果卷积神经网络 ┊782
22.3.2 二维因果卷积神经网络 ┊782
22.4 Transformer ┊783
22.4.1 文本生成 ┊784
22.4.2 图像生成 ┊785
22.4.3 其他应用 ┊786
第23章 归一化流 ┊787
23.1 概述 ┊787
23.1.1 准备工作 ┊787
23.1.2 如何训练流模型 ┊789
23.2 构造流 ┊790
23.2.1 仿射流 ┊790
23.2.2 逐元素流 ┊791
23.2.3 耦合流 ┊793
23.2.4 自回归流 ┊795
23.2.5 残差流 ┊799
23.2.6 连续时间流 ┊802
23.3 应用 ┊803
23.3.1 密度估算 ┊803
23.3.2 生成式建模 ┊804
23.3.3 推理 ┊804
第24章 基于能量的模型 ┊806
24.1 概述 ┊806
24.1.1 示例:专家乘积 ┊807
24.1.2 计算困难 ┊807
24.2 最大似然训练 ┊807
24.2.1 基于梯度的马尔可夫链蒙特卡罗方法 ┊809
24.2.2 对比散度 ┊809
24.3 得分匹配 ┊812
24.3.1 基本得分匹配 ┊813
24.3.2 去噪得分匹配 ┊813
24.3.3 切片得分匹配 ┊815
24.3.4 与对比散度的联系 ┊816
24.3.5 基于得分的生成模型 ┊817
24.4 噪声对比估计 ┊817
24.4.1 与得分匹配的联系 ┊819
24.5 其他方法 ┊819
24.5.1 最小化KL散度的差异/导数 ┊820
24.5.2 最小化Stein差异 ┊820
24.5.3 对抗性训练 ┊821
第25章 扩散模型 ┊823
25.1 概述 ┊823
25.2 去噪扩散概率模型 ┊824
25.2.1 编码器(前向扩散) ┊824
25.2.2 解码器(反向扩散) ┊825
25.2.3 模型拟合 ┊826
25.2.4 学习噪声调度计划 ┊828
25.2.5 示例:图像生成 ┊829
25.3 基于得分的生成模型 ┊829
25.3.1 示例 ┊830
25.3.2 在多个尺度上添加噪声 ┊830
25.3.3 等同于去噪扩散概率模型 ┊831
25.4 使用微分方程的连续时间模型 ┊832
25.4.1 前向扩散随机微分方程 ┊832
25.4.2 前向扩散常微分方程 ┊833
25.4.3 反向扩散随机微分方程 ┊834
25.4.4 反向扩散常微分方程 ┊835
25.4.5 随机微分方程和常微分方程方法的比较 ┊836
25.4.6 示例 ┊836
25.5 加速扩散模型 ┊837
25.5.1 DDIM采样器 ┊837
25.5.2 非高斯解码器网络 ┊837
25.5.3 蒸馏方法 ┊838
25.5.4 潜在空间扩散 ┊839
25.6 条件生成 ┊840
25.6.1 条件扩散模型 ┊840
25.6.2 分类器引导 ┊841
25.6.3 无分类器引导 ┊841
25.6.4 生成高分辨率图像 ┊842
25.7 离散状态空间的扩散 ┊842
25.7.1 离散去噪扩散概率模型 ┊843
25.7.2 前向过程的马尔可夫转移矩阵的选择 ┊844
25.7.3 反向过程的参数化 ┊845
25.7.4 噪声调度计划 ┊845
25.7.5 离散序列与其他概率模型的联系 ┊846
第26章 生成式对抗性网络 ┊847
26.1 概述 ┊847
26.2 通过比较进行学习 ┊849
26.2.1 指导原则 ┊849
26.2.2 使用二元分类器的密度比估计 ┊850
26.2.3 f散度的边界 ┊852
26.2.4 积分概率度量 ┊854
26.2.5 矩匹配 ┊855
26.2.6 关于密度比和密度差异 ┊856
26.3 生成式对抗性网络的训练与优化 ┊858
26.3.1 从学习原理到损失函数 ┊858
26.3.2 梯度下降 ┊859
26.3.3 生成式对抗性网络训练面临的挑战 ┊861
26.3.4 改进生成式对抗性网络优化 ┊862
26.3.5 生成式对抗性网络训练的收敛性 ┊862
26.4 条件生成式对抗性网络 ┊866
26.5 生成式对抗性网络推理 ┊867
26.6 生成式对抗性网络中的神经架构 ┊868
26.6.1 判别器架构的重要性 ┊868
26.6.2 架构归纳偏置 ┊868
26.6.3 生成式对抗性网络中的注意力 ┊869
26.6.4 渐进式生成 ┊870
26.6.5 正则化 ┊871
26.6.6 扩展生成式对抗性网络模型 ┊872
26.7 应用 ┊872
26.7.1 图像生成的生成式对抗性网络 ┊872
26.7.2 视频生成 ┊875
26.7.3 音频生成 ┊875
26.7.4 文本生成 ┊876
26.7.5 模仿学习 ┊877
26.7.6 领域自适应 ┊878
26.7.7 设计、艺术和创意 ┊878
第五部分 发 现
第27章 发现方法:概述 ┊880
27.1 概述 ┊880
27.2 第五部分的内容概述 ┊881
第28章 潜在因子模型 ┊882
28.1 概述 ┊882
28.2 混合模型 ┊883
28.2.1 高斯混合模型 ┊883
28.2.2 伯努利混合模型 ┊885
28.2.3 高斯尺度混合模型 ┊885
28.2.4 使用高斯混合模型作为逆成像问题的先验 ┊887
28.2.5 使用混合模型解决分类问题 ┊890
28.3 因子分析 ┊892
28.3.1 因子分析:基础 ┊892
28.3.2 概率主成分分析 ┊896
28.3.3 混合因子分析器 ┊899
28.3.4 成对数据的因子分析模型 ┊904
28.3.5 指数族似然的因子分析 ┊907
28.3.6 深度神经网络似然的因子分析 ┊908
28.3.7 高斯过程似然的因子分析 ┊909
28.4 具有非高斯先验的潜在因子模型 ┊910
28.4.1 非负矩阵分解 ┊910
28.4.2 多元主成分分析 ┊911
28.5 主题模型 ┊913
28.5.1 潜在狄利克雷分布 ┊914
28.5.2 相关主题模型 ┊917
28.5.3 动态主题模型 ┊918
28.5.4 LDAHMM ┊919
28.6 独立成分分析 ┊922
28.6.1 无噪声独立成分分析模型 ┊922
28.6.2 对非高斯先验的需求 ┊923
28.6.3 最大似然估计 ┊925
28.6.4 最大似然估计的替代方案 ┊925
28.6.5 稀疏编码 ┊927
28.6.6 非线性独立成分分析 ┊928
第29章 状态空间模型 ┊929
29.1 概述 ┊929
29.2 隐马尔可夫模型 ┊930
29.2.1 条件独立性 ┊930
29.2.2 状态转移模型 ┊930
29.2.3 离散似然 ┊931
29.2.4 高斯似然 ┊931
29.2.5 自回归似然 ┊932
29.2.6 神经网络似然 ┊933
29.3 隐马尔可夫模型:应用 ┊934
29.3.1 时间序列分割 ┊934
29.3.2 蛋白质序列比对 ┊936
29.3.3 拼写校正 ┊937
29.4 隐马尔可夫模型:参数学习 ┊940
29.4.1 BaumWelch算法 ┊940
29.4.2 使用随机梯度下降的参数估计 ┊943
29.4.3 使用谱方法的参数估计 ┊944
29.4.4 贝叶斯隐马尔可夫模型 ┊945
29.5 隐马尔可夫模型:泛化 ┊946
29.5.1 隐半马尔可夫模型 ┊946
29.5.2 层次化隐马尔可夫模型 ┊949
29.5.3 因子化隐马尔可夫模型 ┊950
29.5.4 耦合隐马尔可夫模型 ┊951
29.5.5 动态贝叶斯网络 ┊952
29.5.6 变化点检测 ┊952
29.6 线性动力系统 ┊956
29.6.1 条件独立性 ┊956
29.6.2 参数化 ┊956
29.7 线性动力系统:应用 ┊957
29.7.1 目标跟踪和状态估计 ┊957
29.7.2 在线贝叶斯线性回归 ┊958
29.7.3 自适应滤波 ┊960
29.7.4 时间序列预测 ┊960
29.8 线性动力系统:参数学习 ┊960
29.8.1 线性动力系统中的期望最大化 ┊960
29.8.2 子空间识别方法 ┊963
29.8.3 确保动力系统的稳定性 ┊963
29.8.4 贝叶斯线性动力系统 ┊963
29.9 切换线性动力系统 ┊964
29.9.1 参数化 ┊965
29.9.2 后验推理 ┊965
29.9.3 应用:多目标跟踪 ┊966
29.10 非线性状态空间模型 ┊969
29.10.1 示例:目标跟踪和状态估计 ┊969
29.10.2 后验推理 ┊969
29.11 非高斯状态空间模型 ┊970
29.11.1 示例:“尖峰”序列建模 ┊970
29.11.2 示例:随机波动率模型 ┊971
29.11.3 后验推理 ┊972
29.12 结构时间序列模型 ┊972
29.12.1 概述 ┊972
29.12.2 结构化构建块 ┊973
29.12.3 模型拟合 ┊975
29.12.4 预测 ┊975
29.12.5 示例 ┊975
29.12.6 时间序列干预的因果影响 ┊979
29.12.7 Prophet ┊983
29.12.8 神经预测方法 ┊983
29.13 深度状态空间模型 ┊984
29.13.1 深度马尔可夫模型 ┊985
29.13.2 循环状态空间模型 ┊986
29.13.3 改进多步骤预测 ┊986
29.13.4 变分循环神经网络 ┊988
第30章 图学习 ┊989
30.1 概述 ┊989
30.2 图的潜在变量模型 ┊989
30.3 图模型结构学习 ┊989
第31章 非参数化贝叶斯模型 ┊992
31.1 概述 ┊992
第32章 表征学习 ┊993
32.1 概述 ┊993
32.2 评估和比较学习到的表征 ┊994
32.2.1 下游性能 ┊994
32.2.2 表征相似性 ┊996
32.3 学习表征的方法 ┊1000
32.3.1 监督的表征学习和迁移 ┊1001
32.3.2 生成式表征学习 ┊1002
32.3.3 自监督的表征学习 ┊1005
32.3.4 多视图表征学习 ┊1008
32.4 表征学习的理论 ┊1012
32.4.1 可识别性 ┊1013
32.4.2 信息最大化 ┊1014
第33章 可解释性 ┊1016
33.1 概述 ┊1016
33.1.1 可解释性的作用:未知规范和弱规范 ┊1017
33.1.2 术语和框架 ┊1018
33.2 可解释的机器学习方法 ┊1022
33.2.1 内在可解释的模型:模型就是其解释 ┊1022
33.2.2 半内在可解释的模型:基于样例的方法 ┊1024
33.2.3 事后训练或联合训练:解释给出模型的部分视图 ┊1024
33.2.4 透明度和可视化 ┊1028
33.3 属性:上下文和方法之间的抽象 ┊1029
33.3.1 可解释机器学习中解释的属性 ┊1030
33.3.2 认知科学中解释的属性 ┊1032
33.4 可解释机器学习模型的评估 ┊1033
33.4.1 计算评估:该方法是否具有所需的属性 ┊1034
33.4.2 基于用户研究的评估:该方法是否有助于用户执行目标任务 ┊1037
33.5 讨论:如何思考可解释的机器学习 ┊1041
第六部分 行 为
第34章 不确定性决策 ┊1048
34.1 统计决策理论 ┊1048
34.1.1 基础理论 ┊1048
34.1.2 频率学派决策理论 ┊1049
34.1.3 贝叶斯决策理论 ┊1049
34.1.4 贝叶斯方法的频率学派最优性 ┊1050
34.1.5 一次性决策问题示例 ┊1051
34.2 决策(影响)图 ┊1054
34.2.1 示例:石油勘探者 ┊1055
34.2.2 信息弧 ┊1056
34.2.3 信息价值 ┊1057
34.2.4 计算最优策略 ┊1058
34.3 A/B测试 ┊1058
34.3.1 贝叶斯方法 ┊1058
34.3.2 示例 ┊1062
34.4 上下文游戏机 ┊1063
34.4.1 游戏机的类型 ┊1063
34.4.2 应用 ┊1065
34.4.3 “探索-利用”权衡 ┊1065
34.4.4 最优解 ┊1066
34.4.5 置信区间上界 ┊1067
34.4.6 汤普森采样 ┊1069
34.4.7 策略遗憾 ┊1071
34.5 马尔可夫决策问题 ┊1072
34.5.1 基础理论 ┊1072
34.5.2 部分可观测的马尔可夫决策过程 ┊1073
34.5.3 剧集和回报 ┊1074
34.5.4 价值函数 ┊1075
34.5.5 最优价值函数和策略 ┊1076
34.6 马尔可夫决策过程中的规划 ┊1078
34.6.1 价值迭代 ┊1078
34.6.2 策略迭代 ┊1079
34.6.3 线性规划 ┊1080
34.7 主动学习 ┊1081
34.7.1 主动学习场景 ┊1081
34.7.2 与其他形式的序列决策的关系 ┊1082
34.7.3 采集策略 ┊1083
34.7.4 批量主动学习 ┊1085
第35章 强化学习 ┊1088
35.1 概述 ┊1088
35.1.1 方法概述 ┊1089
35.1.2 基于价值的方法 ┊1090
35.1.3 策略搜索方法 ┊1090
35.1.4 基于模型的强化学习 ┊1091
35.1.5 “探索-利用”权衡 ┊1091
35.2 基于价值的强化学习 ┊1093
35.2.1 蒙特卡罗强化学习 ┊1093
35.2.2 时间差分学习 ┊1094
35.2.3 资格迹的时间差分学习 ┊1095
35.2.4 SARSA:同策略时间差分控制 ┊1096
35.2.5 Q学习:异策略时间差分控制 ┊1096
35.2.6 深度Q网络 ┊1099
35.3 基于策略的强化学习 ┊1100
35.3.1 策略梯度定理 ┊1100
35.3.2 REINFORCE ┊1101
35.3.3 “行动者-评论家”方法 ┊1102
35.3.4 边界优化方法 ┊1104
35.3.5 确定性策略梯度方法 ┊1105
35.3.6 无梯度方法 ┊1106
35.4 基于模型的强化学习 ┊1107
35.4.1 模型预测控制 ┊1107
35.4.2 结合基于模型和无模型的强化学习 ┊1109
35.4.3 使用高斯过程的基于模型的强化学习 ┊1109
35.4.4 使用深度神经网络的基于模型的强化学习 ┊1111
35.4.5 使用潜在变量模型的基于模型的强化学习 ┊1112
35.4.6 模型误差的鲁棒性 ┊1114
35.5 异策略学习 ┊1115
35.5.1 基本技术 ┊1115
35.5.2 时域的诅咒 ┊1119
35.5.3 致命的三要素 ┊1120
35.6 作为推理的控制 ┊1122
35.6.1 最大熵强化学习 ┊1122
35.6.2 其他方法 ┊1124
35.6.3 模仿学习 ┊1125
第36章 因果关系 ┊1128
36.1 概述 ┊1128
36.2 因果形式主义 ┊1130
36.2.1 结构因果模型 ┊1130
36.2.2 因果有向无环图 ┊1132
36.2.3 识别 ┊1134
36.2.4 反事实和因果层次 ┊1135
36.3 随机对照试验 ┊1137
36.4 混杂因素调整 ┊1138
36.4.1 因果估计目标、统计估计目标和识别 ┊1138
36.4.2 具有观测到的混杂因素情况下的平均处理效应估计 ┊1141
36.4.3 不确定性量化 ┊1146
36.4.4 匹配 ┊1147
36.4.5 实际考虑和过程 ┊1148
36.4.6 总结和实用建议 ┊1151
36.5 仪器变量策略 ┊1152
36.5.1 加性未观测到的混杂因素 ┊1154
36.5.2 仪器单调性和局部平均处理效应 ┊1155
36.5.3 两阶段最小二乘法 ┊1159
36.6 双重差分法 ┊1159
36.6.1 估计 ┊1162
36.7 可信度检查 ┊1163
36.7.1 安慰剂检查 ┊1163
36.7.2 对未观测到的混杂因素进行敏感性分析 ┊1164
36.8 do演算 ┊1172
36.8.1 三条规则 ┊1172
36.8.2 重新调整后门 ┊1173
36.8.3 前门调整 ┊1174
36.9 参考阅读资料 ┊1175
参考文献 ┊1177
文摘▼
全书通过概率建模和贝叶斯决策理论的统一视角,详细且与时俱进地介绍了机器学习(包括深度学习)的理论和方法。由于篇幅限制,新版分为上下两卷:《概率机器学习(基础篇)》和《概率机器学习(进阶篇)》。本书作为下卷进阶篇,进一步拓展了机器学习的研究范畴,聚焦更具挑战性的问题,力求对机器学习各主题展开更为深入的探讨。
进阶篇主要分为六个部分:第一部分主要讨论机器学习所涉及的数学知识,包括概率论、统计学、图模型、信息论以及优化;第二部分主要讨论机器学习的推理算法,包括高斯滤波与平滑、消息传递算法、变分推理、蒙特卡罗方法、马尔可夫链蒙特卡罗方法以及序列蒙特卡罗方法;第三部分主要讨论机器学习的预测算法,包括广义线性模型、深度神经网络、贝叶斯神经网络、高斯过程以及非独立同分布的假设;第四部分主要讨论机器学习的生成算法,包括变分自动编码器、自回归模型、归一化流、基于能量的模型、扩散模型以及生成式对抗性网络;第五部分主要讨论机器学习的发现方法,包括潜在因子模型、状态空间模型、图学习、非参数化贝叶斯模型、表征学习以及可解释性;第六部分主要讨论机器学习的行为算法,包括不确定性决策、强化学习以及因果关系。