 正版
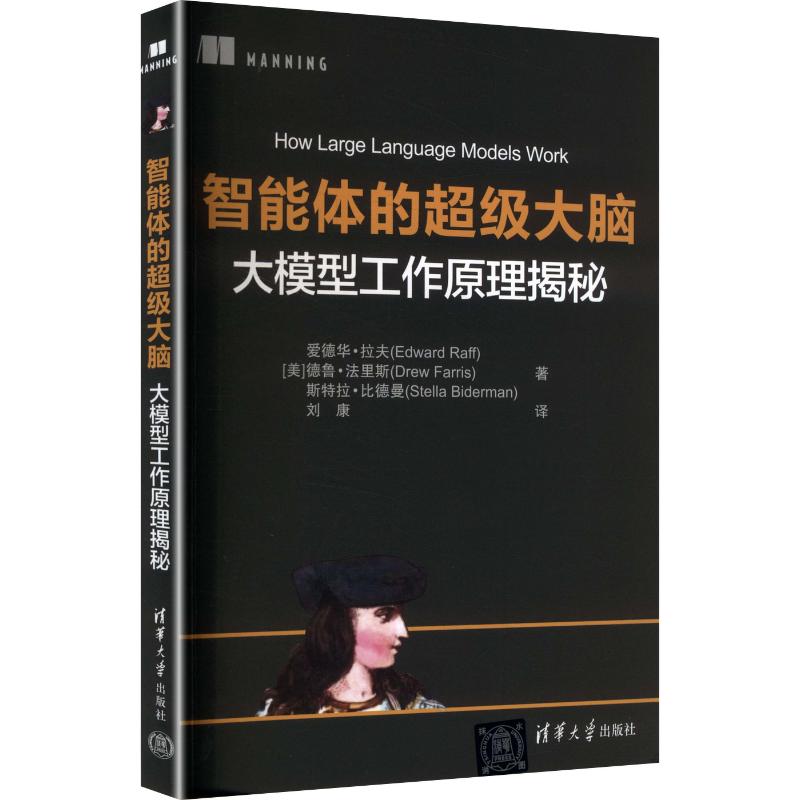
智能体的超级大脑:大模型工作原理揭秘
- 书名
- 智能体的超级大脑:大模型工作原理揭秘
- 作者
- (美)爱德华·拉夫(Edward Raff),(美)德鲁·法里斯(Drew Farris),(美)斯特拉·比德曼(Stella Biderman) 著 刘康 译
- 出版社
- 清华大学出版社
- 出版时间
- 2026-07-01
- ISBN
- 9787302719823
- 货号
- 1204468635
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- 智能体的超级大脑:大模型工作原理揭秘
- 作者
- (美)爱德华·拉夫(Edward Raff),(美)德鲁·法里斯(Drew Farris),(美)斯特拉·比德曼(Stella Biderman) 著 刘康 译
- 出版社
- 清华大学出版社
- 出版时间
- 2026-07-01
- ISBN
- 9787302719823
- 货号
- 1204468635
- 品相
- 全新
- 分类
- 当代·工业
目录▼
第1章宏观视角:什么是大语言模型1
1.1生成式AI的定位2
1.2本书能带给你什么5
1.3LLM工作原理初探7
1.4到底什么是智能9
1.5人类与机器表征语言的方式有何不同10
1.6GPT及其同类模型12
1.7LLM为何表现如此出色13
1.8LLM实战:优势、缺陷与隐患15
本章小结16
第2章分词器:LLM如何“看见”世界19
2.1词元:文本的数值表征形式20
2.2语言模型只能“看见”词元21
2.2.1分词的基本流程23
2.2.2分词过程中的词汇量控制25
2.2.3分词原理详解27
2.2.4分词的潜在风险31
2.3分词与LLM的能力边界33
2.3.1LLM不擅长文字游戏34
2.3.2LLM在数学任务上表现不佳35
2.3.3LLM与语言公平性问题36
2.4自测小练习37
2.5分词的整体定位38
本章小结38
第3章Transformer:从输入到输出41
3.1Transformer模型42
3.2Transformer架构深度解析46
3.2.1嵌入层47
3.2.2Transformer层53
3.2.3反嵌入层56
3.3创造性与主题相关性的权衡60
3.4Transformer的整体定位61
本章小结62
第4章LLM如何学习65
4.1梯度下降66
4.1.1损失函数的定义67
4.1.2什么是梯度下降70
4.2LLM如何模仿人类文本74
4.3LLM与新颖任务79
4.3.1任务识别失败问题82
4.3.2LLM缺乏规划能力83
4.4若LLM外推能力有限,还能使用它们吗84
4.5模型越大越好吗86
本章小结87
第5章如何约束LLM的行为89
5.1约束LLM行为的核心动因91
5.1.1基础模型的实用性局限93
5.1.2模型的部分输出结果不合预期93
5.1.3特定场景对输出格式有严格要求95
5.2微调:改变LLM行为的核心方法95
5.2.1有监督微调96
5.2.2基于人类反馈的强化学习98
5.2.3微调技术全景101
5.3RLHF的工作机制101
5.3.1朴素版RLHF的初步探索101
5.3.2质量奖励模型103
5.3.3平衡质量与相似性的RLHF目标104
5.4定制LLM行为的其他关键因素105
5.4.1调整训练数据106
5.4.2优化基础模型训练流程107
5.4.3调整输出结果108
5.5将LLM集成至复杂工作流109
5.5.1基于检索增强生成的LLM定制109
5.5.2通用LLM编程112
本章小结114
第6章超越自然语言处理117
6.1用于软件开发的LLM119
6.1.1改进LLM以适配代码任务122
6.1.2验证LLM生成的代码123
6.1.3通过格式化优化代码124
6.2面向形式化数学的LLM126
6.2.1输入预处理的挑战127
6.2.2数字理解的优化128
6.2.3数学领域的LLM也会使用工具131
6.3Transformer与计算机视觉133
6.3.1图像与补丁的相互转换134
6.3.2结合图像与文本的多模态模型137
6.3.3既往知识的适用性138
本章小结140
第7章LLM的常见误解、能力局限与卓越优势141
7.1人类与LLM学习速度的对比142
7.1.1自我改进的局限性146
7.1.2少样本学习150
7.2工作效率对比:10瓦的人类大脑与2000瓦的计算机151
7.2.1能源消耗152
7.2.2延迟、可扩展性与可用性153
7.2.3优化改进153
7.3语言模型并非世界模型154
7.4计算局限性:难题依旧难解157
7.4.1用“模糊算法”解决“模糊问题”161
7.4.2对于难题,有时近似解就已足够162
本章小结163
第8章基于LLM设计解决方案165
8.1直接开发一个聊天机器人166
8.2自动化偏见169
8.2.1调整流程171
8.2.2当LLM自主运行风险过高时172
8.3结合多种工具降低风险174
8.3.1LLM嵌入向量与其他工具的结合174
8.3.2基于嵌入向量的解决方案设计177
8.4技术呈现方式至关重要179
8.4.1如何实现透明度181
8.4.2与用户利益对齐181
8.4.3建立反馈循环182
本章小结183
第9章构建与使用LLM的伦理问题185
9.1为何要构建LLM186
9.1.1LLM“无所不能”的利弊187
9.1.2要将人类所有工作都自动化吗189
9.2LLM是否构成生存性风险193
9.2.1自我改进与迭代式S曲线196
9.2.2对齐问题197
9.3数据获取与复用的伦理问题200
9.3.1什么是合理使用201
9.3.2向内容创作者支付报酬面临的挑战203
9.3.3公共领域数据的局限性204
9.4LLM输出内容的伦理担忧205
9.4.1LLM输出内容的许可协议影响206
9.4.2LLM的输出内容是否会毒化数据源208
9.5LLM伦理的其他探索方向211
本章小结212
文摘▼
大语言模型(LLM)让人工智能真正“智能”起来。通过连接数十亿份文档中的词语、概念和模式,LLM能够生成类似人类的回应——这也是我们在ChatGPT、Claude和DeepSeek等工具使用过程中习以为常的体验。在这本兼具知识性与趣味性的书中,博思艾伦咨询公司(Booz Allen Hamilton)全球顶尖的机器学习研究员们,深入探讨了LLM的基础概念、发展机遇与局限性,以及将人工智能融入企业组织和应用程序的最佳实践方法。
这本书带你走进 LLM 的内部世界,一步步解析自然语言提示词如何转化为清晰、易读的文本补全结果。全书以通俗易懂的语言撰写,无须任何机器学习或人工智能基础,你就能学会LLM的构建原理、出错原因,以及如何设计可靠的人工智能解决方案。阅读过程中,你还会了解LLM的“思考”方式、如何设计基于LLM的智能体与问答系统等应用,以及如何应对人工智能领域的伦理、法律和安全问题。