 正版
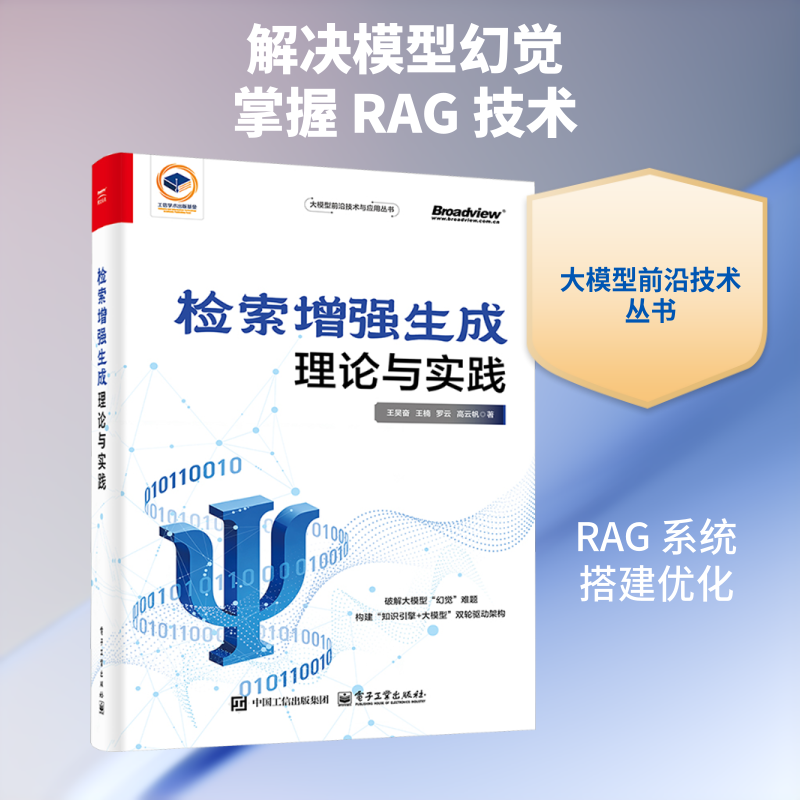
检索增强生成:理论与实践
- 书名
- 检索增强生成:理论与实践
- 作者
- 王昊奋 等 著
- 出版社
- 电子工业出版社
- 出版时间
- 2026-02-01
- ISBN
- 9787121519529
- 货号
- 1204301078
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- 检索增强生成:理论与实践
- 作者
- 王昊奋 等 著
- 出版社
- 电子工业出版社
- 出版时间
- 2026-02-01
- ISBN
- 9787121519529
- 货号
- 1204301078
- 品相
- 全新
- 分类
- 当代·工业
作者简介▼
王昊奋,上海市优秀博士,同济大学百人计划特聘研究员,博士生导师,知识计算研究中心。其研究兴趣及专长是知识图谱、自然语言处理、知识增强大模型。他是全球最大的中文开放知识图谱社区OpenKG轮值主席,通用智能评测社区AGI-Eval发起人之一,国内最大的AI众包平台之一AI-Ceping主理人。出版了《自然语言处理实践》《知识图谱:方法、实践与应用》等著作。他还受邀在世界人工智能大会、IJCAI和VLDB等诸多国际与国内智能峰会上担任讲者,长期作为NeurIPS, ICLR, WWW, MM, AAAI, IJCAI等人工智能国际顶级会议程序委员会委员。负责参与10余项国家自然科学基金重点、面上、863重大专项、科技部重点研发、经信委和科委等AI相关项目,共发表100余篇AI领域高水平论文,多次获得会议最佳论文或最佳学生论文。目前,他担任中国计算机学会术语工委副主任、自然语言处理专委会秘书长、中国中文信息学会理事、大模型专委会指导委员、指控学会大模型专委会常委、上海市计算机学会自然语言处理专委会副主任等社会职位。王楠,博士毕业于德国波鸿鲁尔大学神经信息研究所,前Jina AI联合创始人兼首席技术官,2023年度“中国开源先锋33人”入选者,同时担任Linux基金会AI&DATA TAC成员。作为人工智能与信息检索领域的资深专家,他主导开发包括 jina-embeddings、jina-colbert、jina-reranker、jina-clip在内的多款开源搜索模型,这些模型在全球范围内累计下载量已超过2000万次。王楠博士长期致力于AI技术在自然语言处理与信息检索领域的创新应用,并积极推动 AI技术的开源生态建设,推动DocArray项目从LF AI&DATA毕业。他曾担任中国计算机学会前沿讲习班第147期和第158期讲师,累计为开源社区贡献40余场学术讲座,热心推动AI领域的技术普及与交流。罗云,腾讯云创始团队成员、现任腾讯云数据库副总经理、中国通信标准化协会大数据技术标准推进委员会(CCSA TC601)数据库与存储工作组副组长。行业首本向量数据库丛书《从零构建向量数据库》的作者。十余年云计算产品技术专家,在复杂分布式系统的建设和运营岗位上实践多年并积累了丰富的经验,擅长领导产品、研发、运维和质量等多团队落地重大项目。在职业生涯中,从0到1领导完成国内领先的(Redis/MongoDB/KV存储/时序数据库/向量数据库等)数据库产品的预研、公测、商业化运营。从0到1领导完成国内领先的数据迁移平台(DTS)/腾讯云数据库AI服务(TDAI)等多款数据采集和智能化应用平台产品的上线和商业化运营。 高云帆,同济大学上海自主智能无人系统科学研究中心在读博士研究生,师从王昊奋教授。长期专注于RAG(检索增强生成)、Agent、大模型推荐等前沿方向研究,聚焦RAG技术创新、框架开发及DeepResearch等应用场景拓展。提出大模型与传统推荐系统融合的创新方法ChatRec,单篇引用超500次,牵头撰写大模型时代首篇检索增强领域综述,单篇引用超4000次,成为领域核心参考文献。主导ModularRAG范式构建及对应框架开发,推动RAG技术向模块化、可扩展方向发展,并持续探索RAG与推理的协同优化路径。在TOIS、ACL、AAAI、MM等人工智能领域顶级期刊及会议发表十余篇相关研究成果。
目录▼
推荐序 III
前言 V
第 1 章 检索增强生成概述 1
1.1 RAG 提出的背景 2
1.1.1 大语言模型实际落地的挑战 2
1.1.2 检索增强的生成 3
1.1.3 RAG 的应用场景 4
1.2 什么是 RAG 8
1.2.1 RAG 的定义8
1.2.2 RAG 的发展历程 8
1.2.3 RAG 的基本工作流程10
1.3 RAG 与其他大语言模型优化
技术的对比 14
1.3.1 提示工程15
1.3.2 模型微调15
1.3.3 朴素 RAG 的局限性 16
1.4 本章小结18
第 2 章 RAG 关键技术 19
2.1 数据准备20
2.1.1 业界通用实现20
2.1.2 较成熟的数据准备方案21
2.2 数据索引23
2.2.1 分块优化24
2.2.2 表格数据索引优化25
2.2.3 结构化索引 26
2.2.4 检索源与检索粒度30
2.3 语义检索33
2.3.1 检索前处理 33
2.3.2 检索37
2.3.3 检索后处理 45
2.4 大语言模型生成 49
2.4.1 生成前处理 49
2.4.2 生成51
2.4.3 生成后处理 55
2.5 RAG 流程编排56
2.5.1 路由56
2.5.2 检索与生成的流程调度机制57
2.5.3 融合58
2.6 本章小结59
第 3 章 RAG 典型范式与优化思路 60
3.1 RAG 的主要范式 61
3.1.1 高级 RAG 61
3.1.2 模块化 RAG62
3.1.3 三种 RAG 范式的对比64
3.2 模块化 RAG 的基础流程模式 66
3.2.1 线性模式66
3.2.2 条件模式66
3.2.3 分支模式67
3.2.4 循环模式68
3.3 AgenticRAG: 模块化 RAG 的高阶实现72
3.3.1 为什么需要 AgenticRAG 72
3.3.2 预定义 RAG 工作流 75
3.3.3 动态 RAG 工作流77
3.3.4 AgenticRAG 的优势81
3.4 RAG 系统的优化思路83
3.4.1 增强组件83
3.4.2 重组现有模块83
3.4.3 引入新模块 84
3.5 本章小结85
第 4 章 下游任务与评测 86
4.1 下游评测任务87
4.1.1 知识密集型任务 87
4.1.2 深度研究任务88
4.2 评测维度与基准 91
4.2.1 检索阶段91
4.2.2 生成阶段92
4.2.3 评测基准与框架 93
4.3 RAG 与长上下文 94
4.3.1 大海捞针实验94
4.3.2 RAG 与大海捞针95
4.3.3 嵌入模型与大海捞针 97
4.4 RAG 评测的挑战 98
4.5 本章小结99
第 5 章 RAG 实战 100
5.1 常见开源 RAG 框架 101
5.1.1 LangChain 与 LangGraph101
5.1.2 RAGFlow102
5.1.3 LlamaIndex103
5.1.4 Dify 104
5.2 使用 RAGFlow 搭建 RAG系统105
5.2.1 安装 105
5.2.2 配置模型 107
5.2.3 构建知识库107
5.2.4 构建聊天系统 109
5.2.5 使用 API 访问 113
5.2.6 小结 114
5.3 使用 LangChain 搭建 RAG系统114
5.3.1 安装 LangChain115
5.3.2 Runnable 类的同步调用和
异步调用 116
5.3.3 ChatModel119
5.3.4 Message121
5.3.5 PromptTemplate122
5.3.6 Document、Embeddings、VectorStore 和Retriever 类 123
5.3.7 Graph、State 和 Node 125
5.3.8 Checkpoint 和 MemorySaver 130
5.3.9 搭建朴素 RAG 132
5.4 效果评估139
5.4.1 语义匹配和细颗粒度关键信息 140
5.4.2 评估指标 141
5.4.3 评估数据生成 144
5.5 优化检索模块:语义截断与背景语义缺失 150
5.5.1 语义截断与语义溢出150
5.5.2 背景语义缺失 153
5.6 优化检索模块:嵌入模型155
5.6.1 使用不同的嵌入模型155
5.6.2 微调嵌入模型 157
5.7 优化检索模块:混合检索164
5.8 优化检索模块:添加重排序 167
5.8.1 交叉编码重排序模型167
5.8.2 多向量重排序模型 171
5.9 优化生成模块 172
5.9.1 优化提示词172
5.9.2 选择大语言模型174
5.10 查询预处理 176
5.10.1 查询分解 176
5.10.2 查询等价重写 180
5.10.3 查询泛化重写 181
5.10.4 查询路由 185
5.11 基于智能体的 RAG188
5.12 部署 197
5.12.1 使用腾讯云向量数据库替换本地数据库197
5.12.2 搭建 API 207
5.12.3 使用容器和镜像209
5.12.4 前端 214
5.12.5 监控 221
5.12.6 部署到服务器 222
5.13 本章小结 228
第 6 章 RAG 典型案例 230
6.1 典型工业流程设计 231
6.1.1 OpenAI231
6.1.2 Cohere231
6.1.3 Databricks 232
6.2 RAG 在医疗健康领域的应用233
6.2.1 医学文献知识助手概述 235
6.2.2 系统架构与核心功能设计236
6.2.3 关键技术实现 237
6.2.4 小结 245
6.3 RAG 在金融投资领域的应用245
6.3.1 金融投资助手产生的背景245
6.3.2 关键技术实现 246
6.3.3 小结 255
6.4 本章小结255
第 7 章 挑战与未来展望 257
7.1 RAG 与图结构的融合258
7.1.1 知识组织 258
7.1.2 符号推理 258
7.1.3 任务规划 258
7.1.4 工具使用与管理259
7.2 多模态 RAG259
7.2.1 模态间语义对齐的复杂性259
7.2.2 计算复杂性与系统性能 259
7.2.3 模态间权重动态平衡260
7.2.4 模型可解释性与透明度 260
7.2.5 数据标注与训练的系统性挑战 260
7.2.6 多模态数据协作260
7.3 RAG 与推理能力的结合 261
7.3.1 多步骤复杂任务的挑战 261
7.3.2 逻辑连贯性与知识整合 261
7.3.3 风险传播与安全262
7.3.4 实践应用与场景多样性 262
7.3.5 RAG 的自主流程控制262
7.4 复杂 RAG 系统中的潜在成本 263
7.4.1 计算资源的非线性增长 263
7.4.2 隐性 Token 膨胀264
7.4.3 检索效率的边际下降264
7.4.4 面向效用的 RAG264
7.5 本章小结264
参考文献 265
文摘▼
本书深入解析了检索增强生成技术,该技术通过将大语言模型的内部知识与外部数据源有机结合,显著拓展了模型的认知边界,有效缓解了知识更新滞后与生成幻觉等问题。全书系统性地构建了从理论根基到工程实践的知识脉络,不仅详细剖析了主流RAG技术的实现细节,梳理了从基础范式到智能体驱动的技术演进路径,还构建了多维度的评估体系,并对未来技术趋势进行了前瞻性展望。在实践层面,本书依托主流开发框架与真实案例,提出了适用于不同应用场景的优化策略,帮助读者在医疗、金融等具体领域中灵活运用RAG技术。本书不仅为读者全面梳理并呈现了当前RAG技术的系统化知识体系,更为参与及引领新一代RAG技术创新提供了独到的战略视角与可操作的实践路径。全书内容翔实,结构清晰,辅以丰富的图表与开源代码,便于读者自主实践与深入理解。