 正版
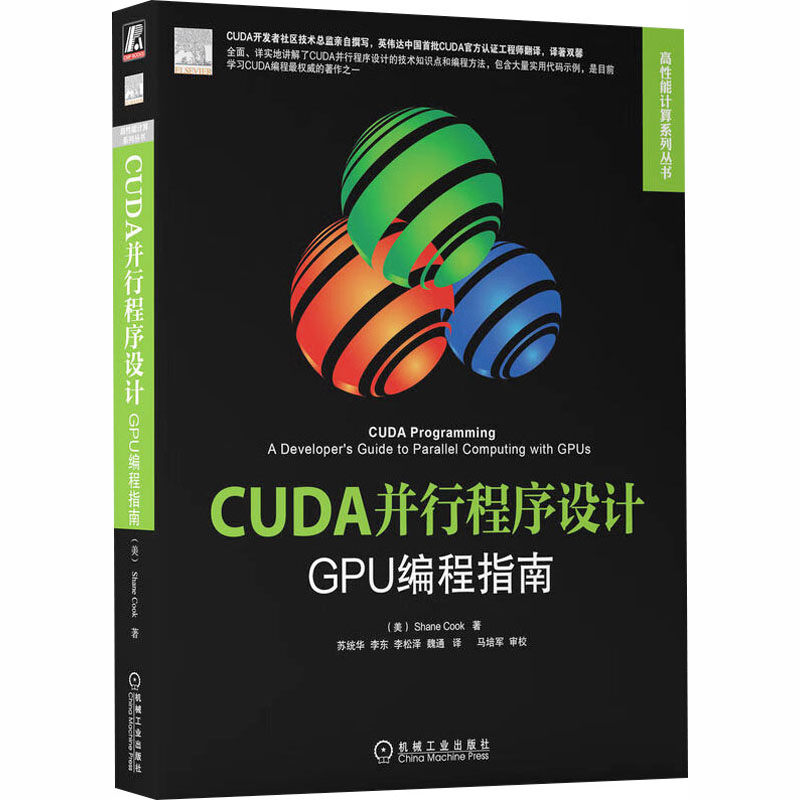
CUDA并行程序设计:GPU编程指南
- 书名
- CUDA并行程序设计:GPU编程指南
- 作者
- (美)库克(Cook,S.) 著 苏统华 等 译
- 出版社
- 机械工业出版社
- 出版时间
- 2025-07-01
- ISBN
- 9787111448617
- 货号
- 1203981737
- 品相
- 全新
- 分类
- 当代·工业
- 书名
- CUDA并行程序设计:GPU编程指南
- 作者
- (美)库克(Cook,S.) 著 苏统华 等 译
- 出版社
- 机械工业出版社
- 出版时间
- 2025-07-01
- ISBN
- 9787111448617
- 货号
- 1203981737
- 品相
- 全新
- 分类
- 当代·工业
作者简介▼
(美)库克,CUDA开发者社区技术总监,有20余年行业经验。当认识到异构系统以及CUDA对于已有串行和并行编程技术的革命性冲击时,创立了CUDA开发者社区(欧洲的咨询公司,专门帮助企业重构代码以充分利用GPU硬件的威力)。他专注于高性能软件开发、GPU利用、嵌入式系统,并参与了多个C语言编程标准的建设,包括广泛应用于汽车软件行业的汽车工业软件MISRASaferC。他常为德国汽车行业、国防承包行业、北电网络以及福特汽车公司等机构或蓝筹股公司提供专业咨询服务和软件定制开发。
苏统华,博士,英伟达中国首批CUDA官方认证工程师,主要研究领域包括大规模并行计算、模式识别、物联网智能信息处理、智能媒体交互与计算等。2013年,其所开发的CUDA识别算法,在文档分析和识别国际会议(ICDAR2013)上获得手写汉字识别竞赛的双料冠军。另外,他在手写汉字识别领域建立了里程碑式的工作,论文他引300余次;他所建立的HIT-MW库,为全世界100多家科研院所采用;目前负责国家自然科学基金项目2项。著有英文专著《Chinese HandwritingRecognition: An Algorithmic Perspective》(德国施普林格出版社),CUDA相关译作2本(机械工业出版社)。现任哈尔滨工业大学软件学院高级讲师、硕士生导师。
马培军,教授、博士生导师、哈尔滨工业大学软件学院院长。20余年行业经验,实践经验十分丰富。曾游学日本,获日本琦玉大学计算机应用专业硕士和博士学位,并在日本佳能集团工作多年。主要研究方向包括:航天软件工程、智能信息处理与信息融合、图像处理与识别、嵌入式系统仿真等。其主持或参加完成多项国家自然科学基金、国家863项目、国防基础科研和国际合作项目,获省部级二等奖2项,软件著作权3项,申请发明专利2项,在国内外期刊和会议上发表论文100余篇。现任哈尔滨工业大学计算机科学与技术学院航天软件工程研究中心主任、中国宇航学会计算机应用专业委员会委员、日本计算机服务公司IT教育顾问。
目录▼
致中国读者
译者序
前言
第1章超级计算简史1
1.1简介1
1.2冯·诺依曼计算机架构2
1.3克雷4
1.4连接机5
1.5Cell处理器6
1.6多点计算8
1.7早期的GPGPU编程10
1.8单核解决方案的消亡11
1.9英伟达和CUDA12
1.10GPU硬件13
1.11CUDA的替代选择15
1.11.1OpenCL15
1.11.2DirectCompute16
1.11.3CPU的替代选择16
1.11.4编译指令和库17
1.12本章小结18
第2章使用GPU理解并行计算19
2.1简介19
2.2传统的串行代码19
2.3串行/并行问题21
2.4并发性22
2.5并行处理的类型25
2.5.1基于任务的并行处理25
2.5.2基于数据的并行处理27
2.6弗林分类法29
2.7常用的并行模式30
2.7.1基于循环的模式30
2.7.2派生/汇集模式31
2.7.3分条/分块33
2.7.4分而治之34
2.8本章小结34
第3章CUDA硬件概述35
3.1PC架构35
3.2GPU硬件结构39
3.3CPU与GPU41
3.4GPU计算能力42
3.4.1计算能力1.042
3.4.2计算能力1.143
3.4.3计算能力1.244
3.4.4计算能力1.344
3.4.5计算能力2.044
3.4.6计算能力2.146
第4章CUDA环境搭建48
4.1简介48
4.2在Windows下安装软件开发工具包48
4.3VisualStudio49
4.3.1工程49
4.3.264位用户49
4.3.3创建工程51
4.4Linux52
4.5Mac55
4.6安装调试器56
4.7编译模型58
4.8错误处理59
4.9本章小结60
第5章线程网格、线程块以及线程61
5.1简介61
5.2线程61
5.2.1问题分解62
5.2.2CPU与GPU的不同63
5.2.3任务执行模式64
5.2.4GPU线程64
5.2.5硬件初窥66
5.2.6CUDA内核69
5.3线程块70
5.4线程网格74
5.4.1跨幅与偏移76
5.4.2X与Y方向的线程索引77
5.5线程束83
5.5.1分支83
5.5.2GPU的利用率85
5.6线程块的调度88
5.7一个实例——统计直方图89
5.8本章小结96
第6章CUDA内存处理99
6.1简介99
6.2高速缓存100
6.3寄存器的用法103
6.4共享内存112
6.4.1使用共享内存排序113
6.4.2基数排序117
6.4.3合并列表123
6.4.4并行合并128
6.4.5并行归约131
6.4.6混合算法134
6.4.7不同GPU上的共享内存138
6.4.8共享内存小结139
6.5常量内存140
6.5.1常量内存高速缓存140
6.5.2常量内存广播机制142
6.5.3运行时进行常量内存更新152
6.6全局内存157
6.6.1记分牌165
6.6.2全局内存排序165
6.6.3样本排序168
6.7纹理内存188
6.7.1纹理缓存188
6.7.2基于硬件的内存获取操作189
6.7.3使用纹理的限制190
6.8本章小结190
第7章CUDA实践之道191
7.1简介191
7.2串行编码与并行编码191
7.2.1CPU与GPU的设计目标191
7.2.2CPU与GPU上的最佳算法对比194
7.3数据集处理197
7.4性能分析206
7.5一个使用AES的示例218
7.5.1算法219
7.5.2AES的串行实现223
7.5.3初始内核函数224
7.5.4内核函数性能229
7.5.5传输性能233
7.5.6单个执行流版本234
7.5.7如何与CPU比较235
7.5.8考虑在其他GPU上运行244
7.5.9使用多个流248
7.5.10AES总结249
7.6本章小结249
第8章多CPU和多GPU解决方案252
8.1简介252
8.2局部性252
8.3多CPU系统252
8.4多GPU系统253
8.5多GPU算法254
8.6按需选用GPU255
8.7单节点系统258
8.8流259
8.9多节点系统273
8.10本章小结284
第9章应用程序性能优化286
9.1策略1:并行/串行在GPU/CPU上的问题分解286
9.1.1分析问题286
9.1.2时间286
9.1.3问题分解288
9.1.4依赖性289
9.1.5数据集大小292
9.1.6分辨率293
9.1.7识别瓶颈294
9.1.8CPU和GPU的任务分组297
9.1.9本节小结299
9.2策略2:内存因素299
9.2.1内存带宽299
9.2.2限制的来源300
9.2.3内存组织302
9.2.4内存访问以计算比率303
9.2.5循环融合和内核融合308
9.2.6共享内存和高速缓存的使用309
9.2.7本节小结311
9.3策略3:传输311
9.3.1锁页内存311
9.3.2零复制内存315
9.3.3带宽限制322
9.3.4GPU计时327
9.3.5重叠GPU传输330
9.3.6本节小结334
9.4策略4:线程使用、计算和分支335
9.4.1线程内存模式335
9.4.2非活动线程337
9.4.3算术运算密度338
9.4.4一些常见的编译器优化342
9.4.5分支347
9.4.6理解底层汇编代码351
9.4.7寄存器的使用355
9.4.8本节小结357
9.5策略5:算法357
9.5.1排序358
9.5.2归约363
9.5.3本节小结384
9.6策略6:资源竞争384
9.6.1识别瓶颈384
9.6.2解析瓶颈396
9.6.3本节小结403
9.7策略7:自调优应用程序403
9.7.1识别硬件404
9.7.2设备的利用405
9.7.3性能采样407
9.7.4本节小结407
9.8本章小结408
第10章函数库和SDK410
10.1简介410
10.2函数库410
10.2.1函数库通用规范411
10.2.2NPP411
10.2.3Thrust419
10.2.4CuRAND434
10.2.5CuBLAS库438
10.3CUDA运算SDK442
10.3.1设备查询443
10.3.2带宽测试445
10.3.3SimpleP2P446
10.3.4asyncAPI和cudaOpenMP448
10.3.5对齐类型455
10.4基于指令的编程457
10.5编写自己的内核464
10.6本章小结466
第11章规划GPU硬件系统467
11.1简介467
11.2CPU处理器469
11.3GPU设备470
11.3.1大容量内存的支持471
11.3.2ECC内存的支持471
11.3.3Tesla计算集群驱动程序471
11.3.4更高双精度数学运算472
11.3.5大内存总线带宽472
11.3.6系统管理中断472
11.3.7状态指示灯472
11.4PCI-E总线472
11.5GeForce板卡473
11.6CPU内存474
11.7风冷475
11.8液冷477
11.9机箱与主板479
11.10大容量存储481
11.10.1主板上的输入/输出接口481
11.10.2专用RAID控制器481
11.10.3HDSL483
11.10.4大容量存储需求483
11.10.5联网483
11.11电源选择484
11.12操作系统487
11.12.1Windows487
11.12.2Linux488
11.13本章小结488
第12章常见问题、原因及解决方案489
12.1简介489
12.2CUDA指令错误489
12.2.1CUDA错误处理489
12.2.2内核启动和边界检查490
12.2.3无效的设备操作491
12.2.4volatile限定符492
12.2.5计算能力依赖函数494
12.2.6设备函数、全局函数和主机函数495
12.2.7内核中的流496
12.3并行编程问题497
12.3.1竞争冒险497
12.3.2同步498
12.3.3原子操作502
12.4算法问题504
12.4.1对比测试504
12.4.2内存泄漏506
12.4.3耗时的内核程序506
12.5查找并避免错误507
12.5.1你的GPU程序有多少错误507
12.5.2分而治之508
12.5.3断言和防御型编程509
12.5.4调试级别和打印511
12.5.5版本控制514
12.6为未来的GPU进行开发515
12.6.1开普勒架构515
12.6.2思考518
12.7后续学习资源519
12.7.1介绍519
12.7.2在线课程519
12.7.3教学课程520
12.7.4书籍521
12.7.5英伟达CUDA资格认证521
12.8本章小结522
文摘▼
计算机软件界大的变迁是从串行编程转向并行编程。其中,CUDA取得了巨大的进展。本书特别针对CUDA学习者而写。在保证程序正确性前提下,侧重于程序性能的调优。对于没有CUDA或者并行编程的任何经验的读者随着本书的深入,将越来越可以胜任CUDA的编程工作,帮助你从不知晓并行编程的程序员成长为能够全方位发掘CUDA潜力的专家。对已经熟悉并行编程概念和CUDA的程序员,本书包含丰富的学习材料,专设章节详细讨论GPU的体系结构,包括新的费米和开普勒硬件,以及如何将它们的效能发挥到极致。任何可以编写C或C++的程序员都可以在经过几个小时的简单训练后编写CUDA程序。通过本书的完整学习,你将从仅能得到数倍程序加速的CUDA编程新手成长为数十倍加速的高手。